05.03.2026
 Tomasz Stelmach

Dlaczego testy wydajnościowe są tak ważne? Bo funkcja, która działa dla jednego użytkownika, nie musi działać dla tysiąca naraz, a wolna aplikacja traci pieniądze tak samo jak zepsuta. Ten tekst nie powtarza definicji i rodzajów testów. Odpowiada na dwa pytania, które zadaje budżet: dlaczego to się opłaca i kiedy test jest naprawdę potrzebny.
Jeśli szukacie przeglądu od podstaw, czyli czym są testy obciążeniowe, stresowe i wytrzymałościowe, jakie metryki zbierać i jakie narzędzia wybrać, opisujemy to w przewodniku testy wydajnościowe: co to jest, rodzaje, metryki i narzędzia. Tutaj zostajemy przy decyzji: pieniądze, ryzyko, terminy i jeden skrypt z progami, który mówi „wydajemy” albo „nie wydajemy”.
Spis treści
- Dlaczego testy wydajnościowe są tak ważne, skoro funkcje działają?
- Ile kosztuje wolna albo niedostępna aplikacja?
- Co się dzieje, gdy szczyt przychodzi bez testu?
- Kiedy test wydajności jest obowiązkowy, a kiedy wystarczy pomiar?
- Jak wygląda test, który odpowiada na pytanie „czy wydajemy”?
- Jak czytać wynik, żeby nie oszukać samych siebie?
- Jak przekonać zarząd do testów wydajnościowych w 15 minut?
Dlaczego testy wydajnościowe są tak ważne, skoro funkcje działają?
Bo testy funkcjonalne sprawdzają, czy system robi to, co powinien, a nie czy zrobi to wystarczająco szybko, gdy przyjdzie tłum. Na demie aplikacja obsługuje jednego klienta z czystą bazą i pustą kolejką zadań. W pierwszej godzinie kampanii ma kilkaset sesji naraz, rosnące tabele, wyczerpaną pulę połączeń do bazy i zewnętrzną bramkę płatności, która też ma swoje limity. Żaden test funkcjonalny tego nie sprawdzi, bo nie po to powstał.
Drugi powód jest mniej oczywisty: użytkownik nie odróżnia „wolnego” od „zepsutego”. Ekran, który ładuje się 8 sekund, dla klienta jest awarią, nawet jeśli w logach wszystko wygląda poprawnie. Dlatego wydajność należy do testów niefunkcjonalnych, ale jej skutki są jak najbardziej funkcjonalne: porzucony koszyk, telefon na infolinię, zła opinia w sklepie z aplikacjami. Klient nie napisze w recenzji, że p95 przekroczył próg. Napisze, że „nic nie działa”, i będzie miał rację.
Ile kosztuje wolna albo niedostępna aplikacja?
Więcej, niż podpowiada intuicja, i da się to policzyć. Badanie Deloitte Digital przygotowane dla Google w 2020 roku objęło 37 marek z Europy i USA i pokazało, że skrócenie czasu ładowania strony mobilnej o 0,1 sekundy zwiększyło konwersję w handlu detalicznym o 8,4 procent, a w turystyce o 10,1 procent. To nie są efekty przebudowy całego serwisu, tylko jednej dziesiątej sekundy.
Ile kosztuje wydajność w liczbach
8,4%
więcej konwersji w handlu po 0,1 s szybszym ładowaniu (Deloitte dla Google, 2020)
90%
średnich i dużych firm płaci ponad 300 000 USD za godzinę przestoju (ITIC, 2024)
41%
dużych firm szacuje godzinę przestoju na 1 do ponad 5 mln USD (ITIC, 2024)
4x
poprzedni szczyt ruchu, który zobaczył Ticketmaster 15.11.2022
Źródło: Deloitte Digital dla Google, Milliseconds Make Millions, 2020; ITIC, 2024 Hourly Cost of Downtime Report, część 1, 2024; Ticketmaster, The Eras Tour Onsale Explained, 2022.
Według raportu ITIC z 2024 roku, opartego na ankiecie wśród ponad 1 000 firm, godzina przestoju kosztuje ponad 300 000 dolarów w ponad 90 procentach średnich i dużych przedsiębiorstw, a 41 procent dużych firm szacuje ją na 1 do ponad 5 mln dolarów. Wasze liczby będą inne, ale mechanizm jest ten sam: każda godzina, w której system nie przyjmuje zamówień albo wniosków w szczycie, ma cenę, którą zna Wasz dział finansów.
Trzeci koszt jest najmniej widoczny: gaszenie pożaru na produkcji. Optymalizacja zapytań do bazy pod presją działającego systemu, w nocy i bez możliwości spokojnego pomiaru, kosztuje wielokrotnie więcej niż ta sama praca przed wydaniem. W naszych projektach widzimy to najwyraźniej w e-commerce: u Argos po automatyzacji testów i uporządkowaniu procesów QA liczba awarii w okresach szczytowych spadła o 72 procent, a konwersja wzrosła o 12 procent dzięki stabilności checkoutu i płatności. Jak testować sklep od strony funkcji i płatności, opisujemy w tekście testowanie e-commerce.
Co się dzieje, gdy szczyt przychodzi bez testu?
Przychodzi i tak, tylko bez ostrzeżenia. Dobrze udokumentowany przykład dał Ticketmaster przy sprzedaży biletów na trasę The Eras Tour Taylor Swift 15 listopada 2022 roku. Firma przyznała w oficjalnym wyjaśnieniu, że ataki botów i fani bez kodów dostępu wygenerowali 3,5 mld żądań do systemu, czyli 4 razy więcej niż poprzedni rekord. Część sprzedaży trzeba było spowolnić albo przesunąć, a według szacunku Ticketmastera problemy dotknęły około 15 procent interakcji w serwisie, w tym błędy walidacji kodów, przez które fani tracili bilety już włożone do koszyka.
Wbrew pozorom
Tego samego dnia Ticketmaster sprzedał ponad 2 mln biletów, najwięcej w historii dla jednego artysty w ciągu jednego dnia. Z punktu widzenia przychodu dzień był rekordowy, a mimo to zapamiętano go jako awarię, która trafiła na pierwsze strony gazet. To dobra lekcja dla każdego, kto mierzy sukces wydania tylko sprzedażą: przy wydajności liczy się też to, ilu klientów odeszło z frustracją, a tego raport sprzedaży nie pokazuje.
Wasz szczyt nie musi mieć 3,5 mld żądań, żeby skończyć się podobnie. Wystarczy kampania mailowa wysłana do całej bazy o 10:00, termin składania wniosków ostatniego dnia miesiąca albo wzmianka w mediach. U Autono, firmy z branży wynajmu samochodów, przygotowanie na sezon pozwoliło utrzymać stabilny system przy obciążeniu większym o 120 procent w wakacje i zmniejszyć liczbę błędów krytycznych w procesach rezerwacji o 55 procent. Różnica między tymi dwoma scenariuszami to test zrobiony przed szczytem, a nie po nim.
Kiedy test wydajności jest obowiązkowy, a kiedy wystarczy pomiar?
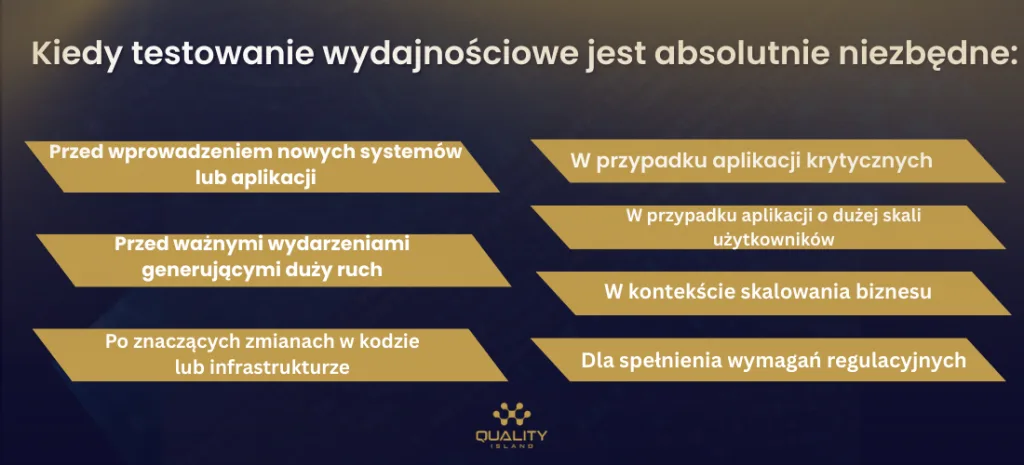
Test jest obowiązkowy, gdy nadchodzi zdarzenie, które zmienia obciążenie albo architekturę, i gdy niedostępność ma cenę wyższą niż sam test. Stały pomiar wystarczy, gdy ruch jest przewidywalny, a zmiany drobne. Poniższa tabela to zestaw sytuacji, które w naszej praktyce najczęściej uzasadniają osobny test.
Źródło: opracowanie Quality Island; rozporządzenie (UE) 2022/2554 (DORA), art. 25 ust. 1.
Wiersz o DORA nie jest przesadą. Rozporządzenie Parlamentu Europejskiego i Rady (UE) 2022/2554 w art. 25 ust. 1 wymienia testy wydajności wprost wśród testów, które przewiduje program testowania operacyjnej odporności cyfrowej, obok testów scenariuszowych, kompleksowych i penetracyjnych, a art. 24 ust. 6 wymaga od podmiotów finansowych innych niż mikroprzedsiębiorstwa testów systemów wspierających krytyczne lub istotne funkcje co najmniej raz w roku. Opisujemy tu wymogi, nie udzielamy porady prawnej; szczegóły i zakres podmiotowy omawiamy w tekście rozporządzenie DORA a testy.
Najtańszy moment na test to etap wymagań: zapisanie, że „lista produktów odpowiada w 95 procentach przypadków poniżej 800 ms przy 180 zamówieniach na minutę”, kosztuje jedno zdanie, a pozwala później mierzyć zamiast dyskutować. Takie progi wpisujcie od razu do planu testów.
Jak wygląda test, który odpowiada na pytanie „czy wydajemy”?
Taki, w którym kryterium sukcesu jest zapisane w kodzie, a nie w głowie testera. Poniższy skrypt w k6 modeluje szczyt kampanii otwartym modelem obciążenia, czyli liczbą zamówień rozpoczynanych na minutę, a nie liczbą wirtualnych użytkowników. To ważne, bo prawdziwi klienci nie czekają, aż system skończy obsługiwać poprzednich: przychodzą w swoim tempie. Liczby w skrypcie są przykładowe, Wy podstawiacie dane z własnej analityki.
import http from 'k6/http';
import { check, sleep } from 'k6';

// Pytanie biznesowe: czy wytrzymamy szczyt kampanii z zapasem 50%?
// Z analityki: 120 zamówień na minutę w szczycie, x 1,5 = 180.
export const options = {
  scenarios: {
    szczyt_kampanii: {
      executor: 'ramping-arrival-rate',
      startRate: 20,
      timeUnit: '1m',
      preAllocatedVUs: 100,
      maxVUs: 400,
      stages: [
        { target: 120, duration: '5m' },  // zwykły szczyt
        { target: 180, duration: '5m' },  // szczyt kampanii z zapasem
        { target: 180, duration: '20m' }, // utrzymanie
        { target: 0, duration: '2m' },
      ],
    },
  },
  thresholds: {
    http_req_failed: ['rate<0.01'],
    'http_req_duration{name:lista_produktow}': ['p(95)<800'],
    'http_req_duration{name:zamowienie}': ['p(95)<1500', 'p(99)<3000'],
    checks: ['rate>0.99'],
  },
};

const BASE = 'https://staging.example.com';

export default function () {
  const lista = http.get(`${BASE}/api/produkty?kategoria=buty`, {
    tags: { name: 'lista_produktow' },
  });
  check(lista, { 'lista 200': (r) => r.status === 200 });
  sleep(3);

  const zamowienie = http.post(
    `${BASE}/api/zamowienia`,
    JSON.stringify({ produktId: 1042, ilosc: 1 }),
    { headers: { 'Content-Type': 'application/json' }, tags: { name: 'zamowienie' } },
  );
  check(zamowienie, { 'zamówienie 201': (r) => r.status === 201 });
}
Każdy próg to osobna decyzja biznesowa. Mniej niż 1 procent nieudanych żądań, lista produktów szybciej niż 800 ms dla 95 procent żądań, zamówienie szybciej niż 1,5 s dla 95 procent i 3 s dla 99 procent. Według dokumentacji k6 wystarczy, że jeden próg nie zostanie spełniony, a cały test kończy się kodem błędu, więc pipeline CI może zatrzymać wydanie bez ludzkiej interpretacji. Testy obciążeniowe uruchamiajcie wyłącznie na środowisku, którym zarządzacie, i uprzedźcie dostawców zewnętrznych API, bo ich limity też są częścią testu.
Jeśli wolicie inne narzędzie, ten sam model zbudujecie w JMeterze, Gatlingu albo Locust. Każde z nich ćwiczymy na osobnym szkoleniu: testowanie wydajnościowe w JMeter, Gatling i Locust.
Jak czytać wynik, żeby nie oszukać samych siebie?
Patrzcie na percentyle i na trend, nie na średnią. Książka Google „Site Reliability Engineering” z 2016 roku pokazuje system, w którym typowe żądanie trwa około 50 ms, a 5 procent żądań jest 20 razy wolniejszych; monitorowanie samej średniej nie pokazywało żadnej zmiany, choć ogon rozkładu zmieniał się mocno w ciągu dnia. Ci najwolniejsi to często klienci z największym koszykiem, bo ich zamówienie dotyka najwięcej danych.
Źródło: opracowanie Quality Island na podstawie praktyki projektowej; Google, Site Reliability Engineering, rozdział 4, 2016.
Wynik testu zawsze odnosicie do pomiaru z prawdziwego ruchu. Po stronie przeglądarki web.dev, serwis zespołu Chrome, podaje progi Core Web Vitals: dobra interakcja to INP do 200 ms, a dobre ładowanie to LCP do 2,5 s, mierzone dla 75. percentyla wizyt. Jeśli test serwera jest zielony, a dane z przeglądarek czerwone, problem siedzi w interfejsie, a nie w backendzie. Kiedy potrzebujecie kogoś, kto przeprowadzi pełną diagnozę z rekomendacjami, to zakres testów wydajności Quality Island.
Jak przekonać zarząd do testów wydajnościowych w 15 minut?
Pokazując rachunek, a nie wykres czasu odpowiedzi. Na pytanie, dlaczego testy wydajnościowe są tak ważne, najlepiej odpowiada kwota w złotych. Zarząd nie kupuje percentyli, kupuje mniejsze ryzyko utraty przychodu. Poniżej przykład liczbowy, który u naszych klientów zajmuje kwadrans, bo wszystkie dane są już w analityce i w finansach. Podstawcie swoje liczby.
krok 1
Przychód w godzinie szczytu
Przykład: kampania przynosi 40 000 zł w najlepszej godzinie. Liczbę bierzecie z analityki z poprzedniej akcji.
krok 2
Scenariusz awarii
Przykład: 3 godziny spowolnienia, w których 30 procent klientów porzuca koszyk. To 3 x 40 000 x 0,3 = 36 000 zł utraconego przychodu.
krok 3
Koszty uboczne
Nadgodziny zespołu, rekompensaty, obsługa reklamacji, wydatek na reklamę, która przyprowadziła ruch donikąd.
krok 4
Koszt testu
Przygotowanie scenariusza, środowiska i analizy. Porównujecie go z sumą kroków 2 i 3, a nie z zerem.
Dobrze działa też porównanie z kosztem opóźnienia wydania, bo test wydajności wykonany za późno kończy się albo ryzykiem, albo przesunięciem terminu. Ten sam sposób myślenia o koszcie dnia opóźnienia opisuje Strefa QA w analizie kosztu regresji przed releasem. Jeśli chcecie zacząć od oceny, gdzie w Waszym procesie brakuje testów niefunkcjonalnych, sprawdzamy to w audycie QA. A jeśli testerzy w Waszym zespole mają przejąć część tej pracy, praktyczne zadania na sprint, łącznie z wyliczeniem obciążenia z analityki, znajdziecie w tekście rola testera w projekcie.
Co zabrać z tego artykułu
01Testy wydajnościowe są tak ważne, bo wolna aplikacja traci pieniądze jak zepsuta: 0,1 s szybciej to 8,4 procent więcej konwersji w handlu według Deloitte dla Google.
02Godzina przestoju kosztuje ponad 300 000 USD w ponad 90 procentach średnich i dużych firm według ITIC 2024. Policzcie własną liczbę przed rozmową o budżecie.
03Test jest obowiązkowy przed kampanią, migracją, nową integracją i terminem ustawowym, a w finansach także z mocy art. 25 ust. 1 DORA.
04Kryteria sukcesu zapiszcie w skrypcie jako progi p95, p99 i błędów. Wtedy pipeline sam odpowiada na pytanie „czy wydajemy”.
05Czytajcie percentyle i trend, nie średnią. Ogon rozkładu to często klienci z największym koszykiem.
Źródło: Deloitte Digital dla Google, 2020; ITIC, 2024; Ticketmaster, 2022; rozporządzenie (UE) 2022/2554; Google SRE, 2016; case studies Argos i Autono, Quality Island.
Macie przed sobą kampanię, migrację albo termin, przy którym system nie może zwolnić? Testy wydajności Quality Island kończą się raportem z progami, wąskimi gardłami i decyzją, czy wydawać.
Powiązane na blogu Quality Island
- Testy wydajnościowe: co to jest, rodzaje, metryki i narzędzia
- Testy niefunkcjonalne: czym są i jak je przeprowadzić
- Rozporządzenie DORA a testy: kto musi i jak często
- Testowanie e-commerce: jak testować sklep internetowy
- Jak napisać plan testów
Pełna lista źródeł
- Deloitte Digital dla Google, Milliseconds Make Millions, 2020. Stąd 37 marek, 8,4 i 10,1 procent konwersji przy 0,1 s szybszym ładowaniu.
- ITIC, ITIC 2024 Hourly Cost of Downtime Report, część 1, 2024. Stąd ponad 300 000 USD za godzinę w ponad 90 procentach firm i 41 procent z kosztem od 1 mln USD.
- Ticketmaster, Taylor Swift | The Eras Tour Onsale Explained, 2022. Stąd 3,5 mld żądań, 4 razy poprzedni szczyt, około 15 procent interakcji z problemami i ponad 2 mln biletów.
- Rozporządzenie Parlamentu Europejskiego i Rady (UE) 2022/2554 (DORA), tekst w EUR-Lex, 2022, art. 24 ust. 6 i art. 25 ust. 1.
- Google, Site Reliability Engineering, rozdział 4: Service Level Objectives, 2016. Stąd przykład 50 ms i 5 procent żądań 20 razy wolniejszych.
- web.dev (Google Chrome), Web Vitals, aktualizacja 2025. Stąd progi LCP 2,5 s i INP 200 ms dla 75. percentyla.
- Grafana Labs, k6, Thresholds oraz Ramping arrival rate, dokumentacja 2026.
- Quality Island, case studies Argos i Autono, 2026, liczby potwierdzone przez klientów.


 5 dni