03.03.2026
 Tomasz Stelmach
Testy API sprawdzają interfejs, przez który systemy wymieniają dane, bez klikania w ekran. Sztuczna inteligencja potrafi dziś pisać takie testy w kilka sekund. Sprawdziliśmy to na publicznym API: model językowy napisał 10 testów z OpenAPI, 3 z nich nie przeszły, a rozstrzygnięcie, czy to błąd API, czy pomyłka modelu, wymagało człowieka.
Poniżej pokazujemy cały eksperyment: prompt, wygenerowany kod, wyniki uruchomienia z 11 października 2026 roku i listę poprawek, które musiał zrobić człowiek. Całość możecie powtórzyć na Waszym API. Obok porównanie z generatorem Schemathesis, który testuje to samo API bez modelu językowego.
Testy API i AI w liczbach
84%
programistów używa narzędzi AI albo planuje ich użycie (Stack Overflow, 2025)
46%
nie ufa dokładności odpowiedzi AI, ufa im 33% (Stack Overflow, 2025)
81%
badanych wskazuje testowanie jako najczęstszą pracę przy API (Postman, 2025)
30
unikalnych błędów znalezionych przez Schemathesis w 87 sekund w naszym teście
Źródło: Stack Overflow Developer Survey 2025; Postman State of the API 2025; przebieg Quality Island na Swagger Petstore, 11.10.2026.
Spis treści
- Czym są testy API i dlaczego to dobre pole dla AI?
- Co sztuczna inteligencja realnie robi w testach API w 2026 roku?
- Eksperyment: testy API wygenerowane z OpenAPI przez model językowy
- Co trzeba było poprawić ręcznie?
- Czy generator ze specyfikacji nie wystarczy? Schemathesis na tym samym API
- Jak połączyć model językowy, generator i człowieka w jednym procesie?
- Gdzie AI w testach API szkodzi zamiast pomagać?
- Od czego zacząć w zespole w pierwszym miesiącu?
Czym są testy API i dlaczego to dobre pole dla AI?
API to umowa: pod danym adresem, z danym żądaniem, serwer odda odpowiedź o określonej strukturze. Testy API sprawdzają, czy ta umowa jest dotrzymana, także dla danych błędnych i granicznych. Są szybsze i stabilniejsze niż testy przez interfejs, bo nie zależą od wyglądu ekranu.
Dla sztucznej inteligencji to wyjątkowo wdzięczny materiał, bo umowa bywa zapisana maszynowo w specyfikacji OpenAPI. Najnowsza wersja tego standardu to 3.2.1 z 10 września 2026 roku. Model dostaje więc listę ścieżek, parametrów, typów i kodów odpowiedzi, z której może wyprowadzić przypadki testowe. Jeśli Wasz zespół ma już taką specyfikację, ma też gotowe wejście dla AI.
Według raportu Postman State of the API 2025, opartego na ankiecie wśród ponad 5 700 osób, 82% organizacji stosuje przynajmniej częściowo podejście API first. Ten sam raport podaje, że testy kontraktowe prowadzi tylko 17% badanych. To duża luka: kontrakty istnieją, ale mało kto sprawdza je automatycznie, a właśnie tu generatory i AI dają najszybszy zwrot.
Co sztuczna inteligencja realnie robi w testach API w 2026 roku?
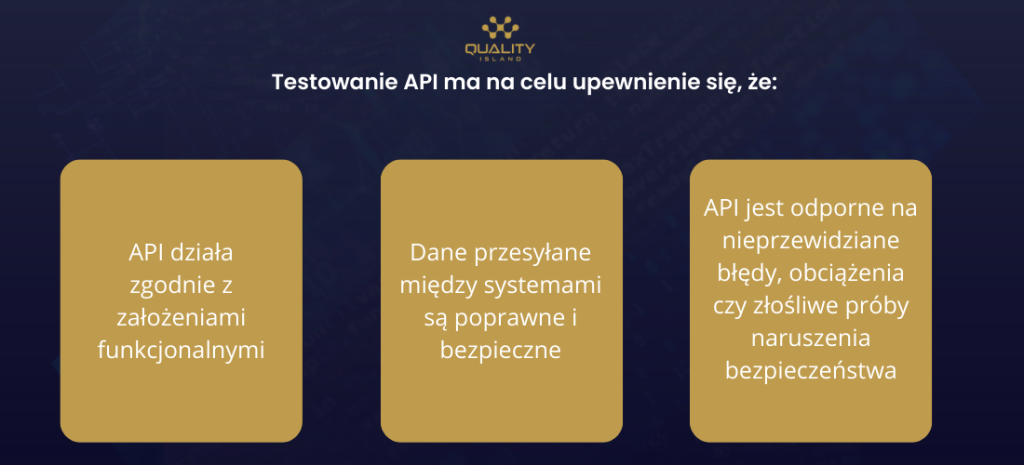
Hasła o „samouczących się testach” warto rozłożyć na konkretne zadania. W naszych projektach AI sprawdza się w czterech miejscach, a w każdym z nich zostaje praca, której nie odda się modelowi.
Źródło: opracowanie Quality Island na podstawie eksperymentu z 11.10.2026 i praktyki projektowej.
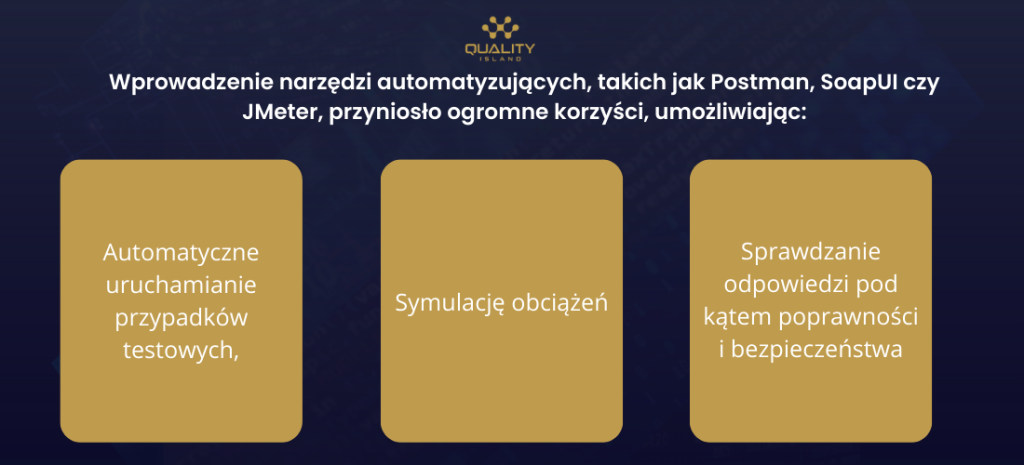
Na grafice wyżej stoją narzędzia, od których zaczynała automatyzacja testów API. Jedna zmiana jest tu ważna: do uruchamiania kolekcji Postmana w CI dokumentacja Postmana zaleca dziś Postman CLI, polecenie postman collection run. Newman nie jest już utrzymywany i nie obsługuje formatu kolekcji v3. Krok po kroku pokazujemy to w kursie Testy API: kurs Postman w 6 lekcjach.
Eksperyment: testy API wygenerowane z OpenAPI przez model językowy
Wzięliśmy publiczną specyfikację Swagger Petstore w wersji 3.0.4 i poprosiliśmy model językowy o testy dla dwóch obszarów: zwierząt i zamówień. Prompt był krótki, taki, jaki tester naprawdę wpisuje w pierwszym podejściu:
Jesteś testerem API. Na podstawie załączonej specyfikacji OpenAPI 3.0.4
(Swagger Petstore, ścieżki /pet i /store/order) napisz testy w Pythonie
z pytest i requests. Uwzględnij ścieżki pozytywne, walidację pól
wymaganych i wartości enum oraz kody 400, 404 i 422.
Każdy test ma być niezależny od pozostałych.
Model oddał 10 testów. Poniżej trzy z nich, bo to one najlepiej pokazują, gdzie zaczyna się praca człowieka:
BASE = "https://petstore3.swagger.io/api/v3"

def test_brak_wymaganego_pola_name_daje_blad_walidacji():
    r = requests.post(f"{BASE}/pet", json={"id": nowe_id(), "photoUrls": []}, timeout=10)
    assert r.status_code in (400, 422)

def test_wyszukiwanie_po_statusie_zwraca_tylko_ten_status():
    r = requests.get(f"{BASE}/pet/findByStatus", params={"status": "sold"}, timeout=10)
    assert r.status_code == 200
    assert all(p["status"] == "sold" for p in r.json())

def test_zamowienie_z_ujemna_iloscia_odrzucone():
    o = {"id": nowe_id(), "petId": 1, "quantity": -5, "status": "placed"}
    r = requests.post(f"{BASE}/store/order", json=o, timeout=10)
    assert r.status_code in (400, 422)
Uruchomiliśmy cały zestaw trzy razy 11 października 2026 roku na publicznym serwerze petstore3.swagger.io. Wynik był powtarzalny: 7 testów przeszło, 3 nie przeszły.
Źródło: przebieg Quality Island, pytest 9.1.1 i requests 2.34.2, Swagger Petstore, 11.10.2026.
Wbrew pozorom
Najgroźniejsze w wygenerowanych testach nie są testy czerwone, tylko zielone. Według Stack Overflow Developer Survey 2025 aż 66% programistów jako największą frustrację wskazuje odpowiedzi AI, które są „prawie dobre, ale nie do końca”. W naszym przebiegu dwa z siedmiu zielonych testów wyglądały poprawnie, a mogły przejść bez sprawdzenia czegokolwiek.
Co trzeba było poprawić ręcznie?
Lista poprawek była dłuższa niż lista błędów API. To typowy obraz, który widzimy u naszych klientów przy pierwszych wdrożeniach AI w testach:
- Reguła wymyślona przez model. Test ujemnej liczby sztuk trzeba było oznaczyć jako pytanie do właściciela produktu, a nie jako błąd API.
- Asercja na pustym zbiorze. Do testu wyszukiwania doszło sprawdzenie, że lista nie jest pusta.
- Niesprawdzony krok przygotowania. Każde utworzenie danych dostało własną asercję kodu odpowiedzi.
- Brak walidacji schematu. Testy sprawdzały kod i jedno pole, a nie całą strukturę odpowiedzi.
- Pominięte uwierzytelnianie. Specyfikacja wymaga OAuth dla /pet, a model nie napisał ani jednego testu odmowy dostępu.
- Współdzielone dane. Losowe identyfikatory na publicznym serwerze nie gwarantują niezależności, którą model obiecał w odpowiedzi.
Model językowy przypomina tu bardzo zdolnego stażystę po kawie: pisze szybko, pewnym tonem i czasem dopisuje wymagania, o które nikt go nie prosił. Zespół zyskał czas na szkielecie, ale bez przeglądu dostałby zestaw, który raz zgłasza nieistniejące błędy, a raz przepuszcza prawdziwe.
Czy generator ze specyfikacji nie wystarczy? Schemathesis na tym samym API
Na to samo API puściliśmy Schemathesis, otwarte narzędzie do testów opartych na właściwościach. Nie używa modelu językowego: generuje żądania wprost ze schematu i sprawdza zgodność odpowiedzi ze specyfikacją.
pip install schemathesis==4.30.1
schemathesis run https://petstore3.swagger.io/api/v3/openapi.json --include-path-regex '^/pet' -n 20 --checks all
Przebieg z 11 października 2026 roku objął 8 operacji z obszaru /pet. Według raportu narzędzia w 87 sekund powstały 623 przypadki testowe, które znalazły 30 unikalnych problemów.
Źródło: przebieg Quality Island, Schemathesis 4.30.1, Swagger Petstore, ścieżki /pet, 11.10.2026.
Generator znalazł więcej i szybciej, ale nie wie, co jest ważne. Brak nagłówka Allow przy metodzie TRACE to drobiazg. Przyjęte błędne uwierzytelnienie to problem bezpieczeństwa z listy OWASP API Security Top 10 2023. Oba stoją w tym samym raporcie, a ich priorytet ustala człowiek.
Jak połączyć model językowy, generator i człowieka w jednym procesie?
Najlepiej działa podział ról, a nie wybór jednego narzędzia. Generator ze schematu pilnuje kontraktu, model językowy pomaga przy scenariuszach biznesowych, a tester decyduje, co jest błędem.
- Kontrakt w repozytorium. Specyfikacja OpenAPI żyje obok kodu i zmienia się w tym samym przeglądzie.
- Generator w CI. Schemathesis albo podobne narzędzie uruchamia się przy każdej zmianie kontraktu.
- Model do scenariuszy. AI proponuje sekwencje typu utwórz, zmień, usuń, a tester je przegląda jak każdy inny kod.
- Asercje schematu. Każdy test sprawdza całą strukturę odpowiedzi, nie tylko kod statusu.
- Kolekcje w Postman CLI. Testy eksploracyjne z Postmana trafiają do pipeline’u przez
postman collection run.
Wdrożenie takiego procesu w istniejącym zespole prowadzimy jako usługę wdrożenia AI w testowaniu, a samą automatyzację jako automatyzację testów API.
Gdzie AI w testach API szkodzi zamiast pomagać?
Są trzy miejsca, w których AI w testach API potrafi zaszkodzić. Pierwsze to fałszywa pewność, którą widać w eksperymencie: zielone testy, które niczego nie sprawdzają. Drugie to dane. Wklejenie do zewnętrznego modelu odpowiedzi z Waszej produkcji z danymi osobowymi to problem z RODO, a nie skrót w pracy.
Trzecie to bezpieczeństwo. Model chętnie napisze testy ścieżek szczęśliwych, a rzadko sam zaproponuje testy autoryzacji na poziomie obiektu, które otwierają listę OWASP API Security Top 10 2023. Te testy Wasz zespół musi zaplanować świadomie. Szerzej o granicach AI w zapewnianiu jakości piszemy na Strefie QA w tekście AI w QA: co działa, a co jeszcze nie działa.
Od czego zacząć w zespole w pierwszym miesiącu?
Z naszego doświadczenia najlepiej sprawdza się mały, mierzalny pilot zamiast deklaracji „wdrażamy AI”. Plan na pierwszy miesiąc może wyglądać tak:
Plan pilotażu na 4 tygodnie
Tydzień 1
uporządkujcie specyfikację OpenAPI jednej usługi i zapiszcie ją w repozytorium
Tydzień 2
uruchomcie generator ze schematu w CI i przejrzyjcie pierwszy raport z zespołem
Tydzień 3
wygenerujcie modelem 10 do 20 testów scenariuszy i policzcie, ile wymagało poprawek
Tydzień 4
porównajcie czas i liczbę znalezionych błędów z dotychczasowym podejściem
Jeśli w Waszym zespole brakuje podstaw, zacznijcie od nich, bo AI wzmacnia kompetencje, ale ich nie zastępuje. Na szkoleniu Wprowadzenie do testowania API Postman przez 2 dni po 7 godzin pracujecie na realnych API. Pracę z modelami w testach przerabiamy na szkoleniu AI w testowaniu oprogramowania oraz w kursie online AI w testowaniu oprogramowania dla testerów i zespołów QA.
Co zabrać z tego artykułu
01Specyfikacja OpenAPI to najlepsze wejście dla AI w testach API, ale tylko 17% badanych przez Postmana w 2025 roku prowadzi testy kontraktowe.
02W naszym eksperymencie model językowy napisał 10 testów: 3 nie przeszły, z czego 1 był jego pomyłką, a 2 z 7 zielonych mogły niczego nie sprawdzać.
03Schemathesis na tym samym API znalazł 30 unikalnych problemów w 87 sekund, bez modelu językowego, ale z szumem do odsiania.
04Najlepszy podział ról: generator pilnuje kontraktu, AI pomaga przy scenariuszach, tester decyduje, co jest błędem.
05Kolekcje Postmana uruchamiajcie w CI przez Postman CLI; Newman nie jest już utrzymywany.
Chcecie sprawdzić, ile AI realnie da Waszym testom API, zanim kupicie licencje? Zróbmy pilotaż na jednej usłudze i policzmy wynik. Ponad 2 500 przeszkolonych specjalistów, ocena 5.0 z ponad 80 opinii Google.
Powiązane na blogu Quality Island
- Testowanie API dla początkujących
- Postman: co to jest, do czego służy i jak zacząć testować API
- Testy API: kurs Postman w 6 lekcjach, od pierwszego żądania do CI
- Metody HTTP: GET, POST, PUT, PATCH i DELETE w testach API
- Testowanie systemów AI: jak zapewnić jakość w erze sztucznej inteligencji
Pełna lista źródeł
- Stack Overflow, Developer Survey 2025, AI, 2025. Stąd 84% używających lub planujących AI, 33% ufających i 46% nieufających dokładności oraz 66% frustracji odpowiedziami „prawie dobrymi”.
- Postman, State of the API Report, 2025. Stąd ponad 5 700 respondentów, 82% organizacji API first, 81% wskazań testowania i 17% testów kontraktowych.
- OpenAPI Initiative, OpenAPI Specification 3.2.1, 10 września 2026. Stąd aktualna wersja standardu.
- Swagger, Swagger Petstore, OpenAPI 3.0.4, odczyt 11.10.2026. API użyte w eksperymencie.
- Schemathesis, Schemathesis documentation, wersja 4.30.1, 2026. Narzędzie użyte w drugiej części eksperymentu.
- Postman, Migrate scripts from Newman to the Postman CLI, 2026. Stąd zalecenie Postman CLI i informacja, że Newman nie jest już utrzymywany.
- OWASP, OWASP API Security Top 10, 2023. Stąd ryzyka autoryzacji na poziomie obiektu i uwierzytelniania.
- IETF, RFC 9110 HTTP Semantics, 2022. Stąd wymóg nagłówka Allow przy odpowiedzi 405.
- Dane własne Quality Island: przebiegi pytest i Schemathesis na Swagger Petstore z 11.10.2026.

 5 dni