05.03.2026
 Tomasz Stelmach

Shift right testing to podejście, w którym część kontroli jakości świadomie przenosicie na etap po wdrożeniu: na produkcję albo środowisko z realnym ruchem. Zamiast pytać tylko „czy wersja przeszła testy”, pytacie też „czy działa dla prawdziwych użytkowników” i odpowiadacie liczbami: testami syntetycznymi, progami SLO, stopniowym wdrożeniem canary i jasną regułą, kiedy wersję wycofać. Shift right nie zastępuje testów przed wydaniem, tylko łapie to, czego żadne środowisko testowe nie odtworzy.
W tym artykule dostajecie konkret, którego zwykle brakuje w tekstach o testowaniu na produkcji: przykład testu syntetycznego w Playwright, tabelę progów SLO z budżetem błędów, rozpisany scenariusz decyzji o wycofaniu canary i checklistę startową w 10 punktach.
Spis treści
- Czym jest shift right testing i czym różni się od shift left?
- Jakie techniki obejmuje testowanie na produkcji?
- Jak napisać test syntetyczny na produkcji?
- Jakie progi SLO i budżet błędów ustawić?
- Jak podjąć decyzję o wycofaniu wersji canary?
- Jak wdrożyć shift right testing krok po kroku?
- Jakie metryki mierzyć po wdrożeniu?
- Jakie są ryzyka i ograniczenia testowania po wdrożeniu?
- Checklista startowa: od czego zacząć w tym tygodniu?
Czym jest shift right testing i czym różni się od shift left?
Shift left przesuwa jakość na początek procesu: analiza wymagań, testy jednostkowe, testy API i bramki w CI. Shift right przesuwa część kontroli na koniec: monitoring, obserwowalność, testy syntetyczne, stopniowe wdrożenia i analizę zachowań użytkowników. Oba podejścia odpowiadają na inne pytanie, więc dojrzałe zespoły stosują oba naraz. Szczegóły lewej strony rozpisujemy w artykule o tym, czym jest shift left testing i jakie ma wady i zalety.
Źródło: opracowanie Quality Island.
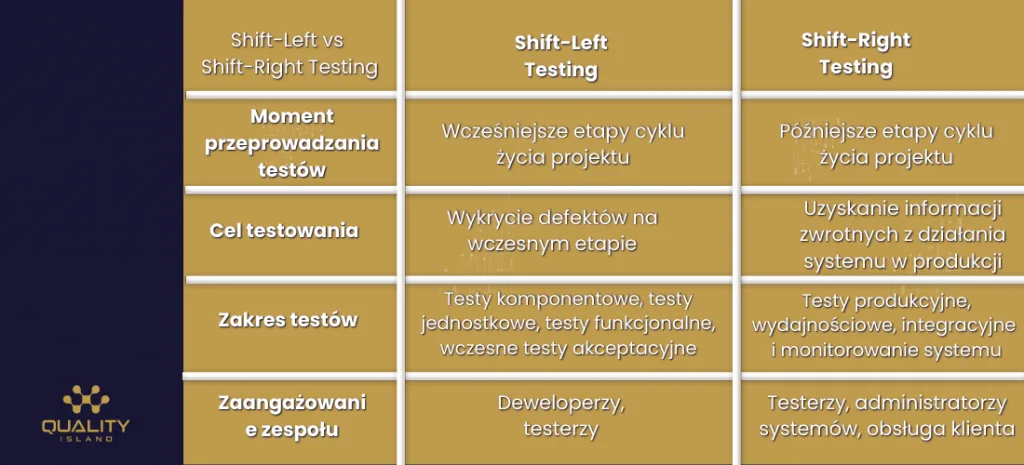
Żadne środowisko testowe nie odtworzy w pełni realnego ruchu, jakości danych produkcyjnych, opóźnień zewnętrznych dostawców ani nietypowych ścieżek, którymi użytkownicy chodzą po aplikacji. Shift right jest szczególnie ważny tam, gdzie wdrożeń jest dużo, a awaria jednej ścieżki to od razu strata: w e-commerce, fintechu, SaaS, systemach rezerwacyjnych i portalach klienta. Pytanie, czy shift right pasuje do Agile, ma prostą odpowiedź: pasuje najlepiej tam, gdzie przyrosty trafiają do użytkowników często, bo tylko wtedy dane z produkcji zdążą wpłynąć na kolejny sprint.
Jakie techniki obejmuje testowanie na produkcji?
Shift right testing to w praktyce kilka technik testowania na produkcji. Testowanie na produkcji brzmi groźnie, ale w dobrze ustawionym procesie to zestaw technik o różnym poziomie ryzyka. Zaczynacie od tych, które niczego nie zmieniają w ruchu użytkowników, a dopiero potem dokładacie techniki, w których część użytkowników widzi nową wersję.
Monitoring i alerty
Dostępność, odsetek błędów, czas odpowiedzi i kluczowe procesy biznesowe. Fundament, bez którego reszta nie ma sensu.
Obserwowalność
Metryki, logi i ślady (traces), które pozwalają odpowiedzieć nie tylko „czy coś się dzieje”, ale „dlaczego”.
Testy syntetyczne
Automatyczne scenariusze uruchamiane cyklicznie na produkcji: logowanie, wyszukiwanie, koszyk, płatność testowa.
Feature flagi
Oddzielają wdrożenie kodu od udostępnienia funkcji. Funkcję włączacie dla zespołu, potem dla grupy, a w razie problemu wyłączacie.
Canary release
Nowa wersja dostaje mały procent ruchu, a decyzja o kolejnym kroku zależy od metryk porównanych z wersją bazową.
Testy A/B i analiza zachowań
Porównanie wariantów na realnych użytkownikach, z metrykami jakości obok konwersji: błędy, porzucenia, zgłoszenia.
DORA w opisie praktyki monitoringu i obserwowalności zalicza dobre monitorowanie do zdolności technicznych, które wspierają wysoką skuteczność dostarczania oprogramowania. W praktyce oznacza to, że bez sensownego monitoringu nie da się bezpiecznie wdrażać często, a bez częstych wdrożeń shift right traci połowę sensu.
Jak napisać test syntetyczny na produkcji?
Test syntetyczny to najprostszy punkt wejścia w shift right testing: zwykły test end to end, tylko uruchamiany cyklicznie na żywym systemie, na specjalnym koncie i danych, które nie zaśmiecają statystyk biznesowych. Dobrze sprawdza się na kilku krytycznych ścieżkach, a nie na całej regresji. Przykład w Playwright dla sklepu internetowego:
import { test, expect } from '@playwright/test';

// Konto i produkt syntetyczny: wykluczone z analityki, płatność w trybie testowym
const BASE = process.env.SYNTH_BASE_URL ?? 'https://sklep.example.com';

test('synthetic: logowanie i dodanie do koszyka', async ({ page }) => {
  await page.goto(BASE);
  await page.getByRole('link', { name: 'Moje konto' }).click();
  await page.getByLabel('E-mail').fill(process.env.SYNTH_USER!);
  await page.getByLabel('Hasło').fill(process.env.SYNTH_PASS!);
  await page.getByRole('button', { name: 'Zaloguj' }).click();
  await expect(page.getByRole('heading', { name: 'Panel klienta' }))
    .toBeVisible({ timeout: 5000 });

  await page.goto(`${BASE}/produkt/synth-sku-001`);
  await page.getByRole('button', { name: 'Dodaj do koszyka' }).click();
  await expect(page.getByTestId('licznik-koszyka')).toHaveText('1');

  // sprzątanie: koszyk syntetyczny nie może rosnąć z każdym przebiegiem
  await page.getByTestId('wyczysc-koszyk').click();
});
Uruchomienie co 5 minut to według dokumentacji GitHub Actions najkrótszy odstęp, na jaki pozwala harmonogram, a dla większości ścieżek biznesowych w zupełności wystarcza. Fragment konfiguracji:
name: synthetic-checks
on:
  schedule:
    - cron: '*/5 * * * *'
jobs:
  synthetic:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
      - uses: actions/setup-node@v4
        with:
          node-version: 22
      - run: npm ci
      - run: npx playwright install --with-deps chromium
      - run: npx playwright test tests/synthetic --project=chromium
        env:
          SYNTH_BASE_URL: https://sklep.example.com
          SYNTH_USER: ${{ secrets.SYNTH_USER }}
          SYNTH_PASS: ${{ secrets.SYNTH_PASS }}
Trzy zasady, które oddzielają test syntetyczny od kłopotu. Po pierwsze, konto i dane syntetyczne są oznaczone i wykluczone z analityki, raportów sprzedaży i newslettera. Po drugie, test sprząta po sobie i nigdy nie wykonuje nieodwracalnej operacji na prawdziwych pieniądzach. Po trzecie, alert z testu syntetycznego trafia do tej samej osoby dyżurnej co alert z monitoringu, inaczej po tygodniu nikt go nie czyta. Test syntetyczny, którego alertów nikt nie czyta, pełni w zespole tę samą funkcję co czujnik dymu bez baterii: uspokaja wszystkich do pierwszego pożaru.
Jeśli dopiero budujecie automatyzację, z której potem wydzielicie testy syntetyczne, podstawy Playwright z pipeline w CI przerabiamy na szkoleniu Automatyzacja testów z narzędziem Playwright. Szerzej o samych testach przekrojowych piszemy w artykule o testach end to end.
Jakie progi SLO i budżet błędów ustawić?
SLO (Service Level Objective) to według rozdziału o SLO w książce Google Site Reliability Engineering docelowa wartość albo zakres wartości poziomu usługi mierzonego wskaźnikiem SLI. Prościej: SLI to to, co mierzycie, na przykład odsetek udanych żądań, a SLO to próg, który uznajecie za wystarczający. Różnica między 100 procent a SLO to budżet błędów, czyli ilość „zepsucia”, na którą Was stać w danym okresie.
Źródło: obliczenia Quality Island: 30 dni to 43 200 minut, budżet to (100% minus SLO) razy 43 200 minut.
Próg wybieracie z biznesem, nie z ambicji, bo to Wasi użytkownicy, a nie wykres, decydują, ile przestoju zniosą. SLO 99,99 procent dla panelu raportowego, który klienci otwierają raz w tygodniu, to koszt bez korzyści. Dla shift right testing ważniejsze od samego progu są dwie decyzje zapisane z góry: jakie SLI wchodzą do oceny wersji canary i co się dzieje, gdy budżet się kończy.
Na drugie pytanie przykładową odpowiedź daje polityka budżetu błędów z Google SRE Workbook: jeśli usługa przekroczyła budżet błędów w poprzednim czterotygodniowym oknie, wstrzymuje się wszystkie zmiany i wydania poza poprawkami P0 i bezpieczeństwa, dopóki usługa nie wróci w granice SLO. Nie musicie kopiować tej reguły dosłownie, ale warto mieć jakąś, spisaną i zaakceptowaną przez Product Ownera, zanim pierwszy raz zabraknie budżetu.
Przykładowy zestaw SLI dla ścieżki zakupu
99,9%
udanych żądań API koszyka i płatności (bez kodów 5xx)
p95 < 400 ms
czas odpowiedzi API koszyka mierzony na serwerze
98%
udanych przebiegów testu syntetycznego w oknie 1 godziny
±10%
dopuszczalne odchylenie konwersji koszyka canary od wersji bazowej
Źródło: progi przykładowe opracowane przez Quality Island do tego artykułu; definicje SLI i SLO według Google SRE.
Jak podjąć decyzję o wycofaniu wersji canary?
Canary release to technika shift right testing, która polega na skierowaniu małej części ruchu do nowej wersji i porównaniu jej metryk z wersją bazową. Jeśli metryki są w normie, udział ruchu rośnie, jeśli nie, cały ruch wraca do wersji bazowej. Dla Was najważniejsze jest to, że decyzja zapada na podstawie danych z produkcji, a nie przeczucia.
Wbrew pozorom
Wersja, która psuje co piąte żądanie, nie musi oznaczać katastrofy. W przykładzie z rozdziału o canary w Google SRE Workbook (2018) nowa wersja zwraca błąd w 20 procentach żądań, ale dostaje tylko 5 procent ruchu, więc całkowity odsetek błędów usługi wynosi 1 procent. Zużycie budżetu błędów jest wprost proporcjonalne do ruchu wystawionego na defekt, dlatego wielkość pierwszego kroku canary jest decyzją o ryzyku, a nie szczegółem konfiguracji.
Poniżej scenariusz przykładowy, opracowany do tego artykułu, a nie opis konkretnego wdrożenia. Sklep obsługuje 100 milionów żądań miesięcznie, SLO dostępności wynosi 99,9 procent, więc miesięczny budżet to 100 000 nieudanych żądań. Nowa wersja koszyka idzie w krokach 5, 25, 50 i 100 procent ruchu, po 30 minut na krok.
Źródło: scenariusz przykładowy Quality Island; wartości ilustracyjne.
Dwie z czterech metryk przekraczają próg, więc decyzja jest jedna: wycofanie canary i powrót całego ruchu do wersji bazowej. Ważne jest, że tę decyzję podjęto przed wdrożeniem, zapisując progi, a nie w trakcie, pod presją terminu. Rachunek pokazuje, ile kosztowała ostrożność: przez 30 minut canary obsłużył około 3 472 żądań, z których przy 0,8 procent błędów nie powiodło się około 28, czyli 0,03 procent miesięcznego budżetu. Ta sama wersja wdrożona od razu na 100 procent ruchu przez te same 30 minut dałaby około 556 nieudanych żądań, dwadzieścia razy więcej.
Zauważcie też, że test syntetyczny i konwersja były w normie. Gdyby decyzja opierała się tylko na nich, wersja poszłaby dalej. Dlatego do oceny canary bierzecie kilka SLI naraz i zapisujecie regułę, ile z nich może być przekroczonych, zanim nastąpi wycofanie. W najprostszej wersji: jedno przekroczenie dowolnego progu technicznego wstrzymuje rollout.
W Kubernetesie taką regułę da się zautomatyzować, na przykład w Argo Rollouts. Dokumentacja analizy w Argo Rollouts pokazuje szablon, który co minutę odpytuje Prometheusa i przerywa rollout, gdy warunek sukcesu nie jest spełniony określoną liczbę razy:
apiVersion: argoproj.io/v1alpha1
kind: AnalysisTemplate
metadata:
  name: odsetek-udanych-zadan
spec:
  args:
    - name: service-name
  metrics:
    - name: success-rate
      interval: 1m
      successCondition: result[0] >= 0.999
      failureLimit: 2
      provider:
        prometheus:
          address: http://prometheus.monitoring:9090
          query: |
            sum(rate(http_requests_total{service="{{args.service-name}}",code!~"5.."}[5m]))
            /
            sum(rate(http_requests_total{service="{{args.service-name}}"}[5m]))
Monitoring i testowanie aplikacji uruchamianych w Kubernetesie, razem z Prometheusem i Grafaną, przerabiamy na szkoleniu Testowanie i monitoring aplikacji w Kubernetesie, a sam pipeline z bramkami jakości buduje się w ramach usługi budowy procesów CI/CD.
Jak wdrożyć shift right testing krok po kroku?
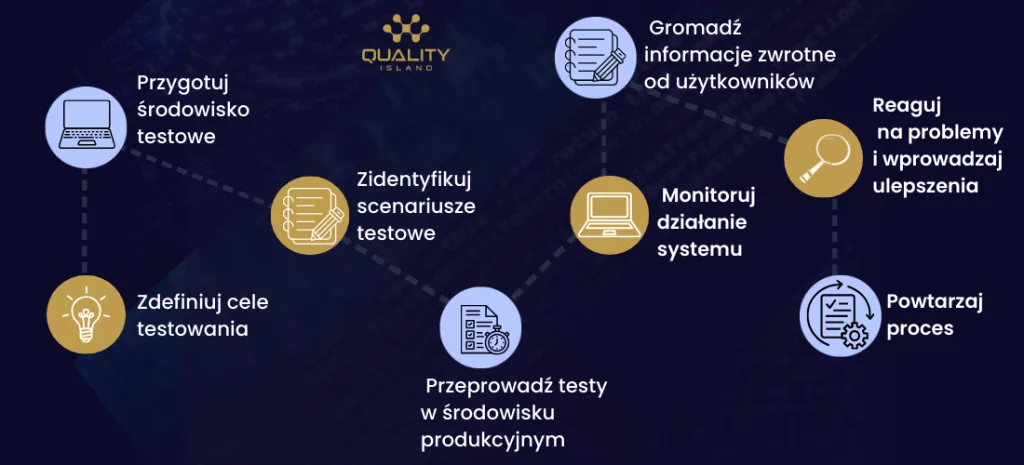
- Wybierzcie 3 do 5 krytycznych ścieżek. Logowanie, zakup, płatność, wysłanie wniosku. Tam, gdzie awaria to od razu strata albo reklamacja.
- Zdefiniujcie SLI i SLO dla każdej ścieżki. Odsetek udanych żądań i czas odpowiedzi, z progiem uzgodnionym z biznesem.
- Włączcie QA w projektowanie alertów. Testerzy znają przypadki brzegowe i wiedzą, który błąd boli użytkownika, a który tylko serwer.
- Dodajcie testy syntetyczne. Wydzielcie z regresji kilka testów krytycznych ścieżek i uruchamiajcie je cyklicznie na produkcji.
- Wprowadźcie feature flagi. Oddzielcie wdrożenie kodu od udostępnienia funkcji, żeby wyłączenie nie wymagało nowego wydania.
- Zaplanujcie canary z progami. Kroki ruchu, czas na krok, lista SLI i reguła wycofania zapisana przed wdrożeniem.
- Ustalcie zasady wycofania. Kto decyduje, w jakim czasie, jak informujecie wsparcie klienta i jak dokumentujecie incydent.
- Zamknijcie pętlę. Każdy incydent produkcyjny kończy się pytaniem, dlaczego testy go nie złapały, i nowym przypadkiem w regresji albo monitoringu.
Przy wdrażaniu shift right testing w naszych projektach najszybciej działa kolejność: najpierw kroki 1, 2 i 4, czyli ścieżki, SLI i testy syntetyczne, a dopiero potem flagi i canary. Wasz zespół zobaczy pierwsze dane z produkcji po kilku dniach, zanim zmieni się cokolwiek w procesie wydań.
Ten proces łączy QA, DevOps i biznes, dlatego dobrze się go wdraża jako część podejścia TestOps i QualityOps. Jeśli chcecie zrobić to z zewnętrznym wsparciem, opis zakresu jest na stronie usługi TestOps i QualityOps.
Jakie metryki mierzyć po wdrożeniu?
Shift right testing bez metryk byłby tylko obserwowaniem wykresów. Dobre metryki łączą trzy perspektywy: techniczną, jakościową i biznesową. DORA w przewodniku po metrykach mierzy niestabilność dostarczania dwoma wskaźnikami: odsetkiem wdrożeń wymagających natychmiastowej interwencji (change fail rate) i odsetkiem nieplanowanych wdrożeń wynikających z incydentu (deployment rework rate), a obok nich czasem przywrócenia działania po nieudanym wdrożeniu. To dobry szkielet, do którego dokładacie metryki QA i biznesowe.
Źródło: DORA metrics guide, opracowanie Quality Island.
Spadek konwersji nie zawsze oznacza defekt: może wynikać z sezonowości, kampanii albo awarii zewnętrznego dostawcy. Dlatego decyzje opieracie na porównaniu canary z wersją bazową w tym samym czasie, a nie na porównaniu dziś z wczoraj. Jak przełożyć te liczby na język zarządu, piszemy w artykule o KPI QA dla zarządu.
Jakie są ryzyka i ograniczenia testowania po wdrożeniu?
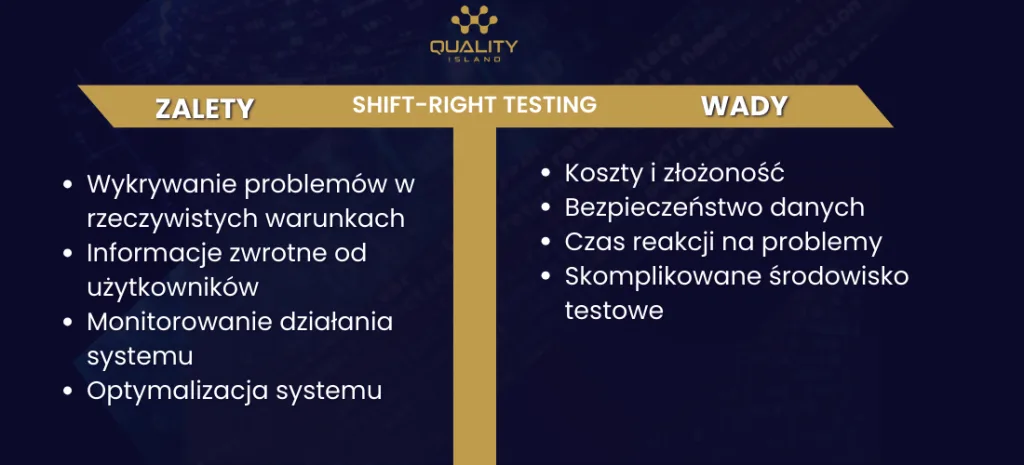
- Testowanie na klientach zamiast testów. Największy błąd przy wdrażaniu shift right testing to uznanie, że skoro jest monitoring, można słabiej testować przed wydaniem. To nie jest shift right, tylko przerzucenie ryzyka na użytkownika.
- Niedojrzała infrastruktura. Bez metryk, logów, flag i szybkiego wycofania testowanie po wdrożeniu jest niebezpieczne.
- Zmęczenie alertami. Zbyt wiele alertów sprawia, że ludzie przestają reagować. Alert ma sens tylko wtedy, gdy wiąże się z wpływem na użytkownika.
- Prywatność danych. Analiza zachowań i logów musi być zgodna z RODO, a QA nie powinno mieć niekontrolowanego dostępu do danych osobowych z produkcji.
- Interpretacja danych. Nie każda zmiana metryki to defekt, więc decyzje opieracie na porównaniu z wersją bazową i progach zapisanych wcześniej.
Dobrą, zdroworozsądkową perspektywę na granice tego podejścia daje tekst na Strefie QA o tym, dlaczego testowanie na produkcji bywa mądrym wyborem, ale rzadko. Jeśli problemy z wydajnością wychodzą Wam dopiero pod realnym ruchem, warto też wrócić na lewą stronę i zaplanować testy wydajności na danych z produkcji.
Nasza perspektywa: shift right działa, kiedy stoi na solidnej lewej stronie.
Pierwsza obserwacja. W case Argos z naszej bazy awarie w okresach szczytowych spadły o 72 procent, a regresja przed wydaniem skróciła się z 5 dni do 10 godzin dzięki automatyzacji i uporządkowaniu procesów QA, czyli pracy po lewej stronie. Monitoring po wdrożeniu nie zastąpiłby tej pracy, mógłby najwyżej szybciej pokazać jej brak.
Druga obserwacja. Z naszego doświadczenia najszybciej zwracają się testy syntetyczne na trzech, czterech ścieżkach, bo często już istnieją w regresji i wystarczy je uruchomić na produkcji z osobnym kontem.
Trzecia obserwacja. Najczęściej brakuje nie narzędzi, tylko zapisanej decyzji: kto wycofuje wersję i przy jakich progach. Ta kartka papieru kosztuje godzinę spotkania, a oszczędza nerwy przy każdym wydaniu.
Checklista startowa: od czego zacząć w tym tygodniu?
Źródło: checklista Quality Island.
Co zabrać z tego artykułu
01Shift right testing przenosi część kontroli jakości na produkcję, ale nie zastępuje testów przed wydaniem.
02Test syntetyczny to test krytycznej ścieżki uruchamiany cyklicznie na produkcji, na koncie i danych wykluczonych z analityki.
03SLO 99,9 procent daje 43,2 minuty budżetu błędów w 30 dniach; próg wybieracie z biznesem, nie z ambicji.
04Decyzję o wycofaniu canary opieracie na kilku SLI porównanych z wersją bazową i progach zapisanych przed wdrożeniem.
05Najtańszy pierwszy krok: spisana reguła, kto wycofuje wersję i przy jakich progach.
Źródło: Google SRE Book i SRE Workbook, DORA, Argo Rollouts, opracowanie Quality Island.
Chcecie połączyć testy, monitoring i decyzje o wydaniach w jeden proces? Pomożemy ustawić SLO, testy syntetyczne i reguły canary w ramach TestOps.
Powiązane na blogu Quality Island
- Shift left testing: wady i zalety
- Testy end to end: co sprawdzają i jak je planować
- Testy wydajnościowe: rodzaje, metryki i narzędzia
- Jak skrócić testy regresyjne z 5 dni do 10 godzin: case Argos
- KPI dla zarządu: jak przełożyć wyniki QA na język CFO
Pełna lista źródeł
- Google, Site Reliability Engineering, rozdział Service Level Objectives, O’Reilly 2016, wydanie online.
- Google, The Site Reliability Workbook, rozdział Canarying Releases, O’Reilly 2018, wydanie online.
- Google, The Site Reliability Workbook, Example Error Budget Policy, 2018.
- DORA, DORA metrics: the four keys and beyond, przewodnik, aktualizacja 5 stycznia 2026, oraz Monitoring and observability, strona zdolności technicznych, odczyt 11.10.2026.
- GitHub, Events that trigger workflows: schedule, dokumentacja, 2026.
- Argo Project, Argo Rollouts: Analysis and Progressive Delivery, dokumentacja, 2026.
- Dane własne Quality Island, 2026: case study Argos (spadek awarii w okresach szczytowych o 72 procent, regresja z 5 dni do 10 godzin), liczby potwierdzone przez klienta.


 5 dni