09.03.2026
 Tomasz Stelmach
Jakość oprogramowania to stopień, w jakim produkt spełnia zapisane i domyślne potrzeby swoich interesariuszy: użytkowników, klienta, zespołu, który go utrzymuje. Tak ujmuje ją model ISO/IEC 25010, a jego aktualne wydanie z listopada 2023 roku rozkłada jakość na dziewięć charakterystyk. Żeby jakość dało się mierzyć, a nie tylko o niej dyskutować, potrzebujecie dwóch rzeczy: wspólnego słownika cech i kilku liczb liczonych zawsze tak samo.
W tym artykule dostajecie oba elementy. Najpierw dziewięć charakterystyk z ISO/IEC 25010:2023, z tym, co zmieniło się względem wydania z 2011 roku. Potem siedem metryk z wzorami i przykładowymi obliczeniami: DDP, gęstość defektów, defekty, które uciekły na produkcję, wskaźniki DORA i Core Web Vitals. Na końcu plan na pierwszy miesiąc pomiaru.
Spis treści
- Czym jest jakość oprogramowania według ISO/IEC 25010:2023?
- Jakie charakterystyki jakości opisuje norma?
- Co zmieniło się względem wydania z 2011 roku?
- Dlaczego opisy słowne nie wystarczą?
- Jakie metryki jakości oprogramowania warto liczyć?
- Jak policzyć DDP, czyli skuteczność wykrywania defektów?
- Dlaczego waga błędu zmienia obraz jakości?
- Jakie progi ustawić i w jakie pułapki nie wpaść?
- Jak połączyć metryki z głosem użytkowników?
- Od czego zacząć pomiar w Waszym zespole?
Czym jest jakość oprogramowania według ISO/IEC 25010:2023?
ISO/IEC 25010:2023 to norma z rodziny SQuaRE, która definiuje model jakości produktu dla produktów ICT i oprogramowania. Według opisu normy na stronie ISO model składa się z dziewięciu charakterystyk, dzielonych dalej na podcharakterystyki, i służy do specyfikowania, mierzenia i oceny jakości przez cały cykl życia produktu. ISO wymienia wprost zastosowania, które dotyczą Was bezpośrednio: definiowanie wymagań, wyznaczanie celów testów, kryteria kontroli jakości i kryteria akceptacji.
To ważne rozróżnienie. Norma nie mówi, ile defektów to „dużo”, ani nie podaje progów. Daje słownik, dzięki któremu klient, programista i tester mówią o tym samym, gdy używają słowa „niezawodność”. Liczby i progi dobieracie sami, pod ryzyko swojego produktu. Wydanie 2023 zastąpiło wydanie 2011, które ISO oznacza dziś jako wycofane.
Jakie charakterystyki jakości opisuje norma?
Poniżej dziewięć charakterystyk z modelu jakości produktu ISO/IEC 25010:2023, z podcharakterystykami i przykładem metryki, którą możecie podpiąć pod każdą z nich. Nazwy polskie to nasze robocze tłumaczenia, w nawiasie nazwa angielska z normy.
Źródło: ISO, ISO/IEC 25010:2023, opis normy na iso.org (dziewięć charakterystyk, wydanie 2, 2023-11); podcharakterystyki według zestawienia iso25000.com. Przykłady metryk: Quality Island.
Nie musicie mierzyć wszystkich dziewięciu naraz. Ustalcie z klientem albo właścicielem produktu dwie lub trzy charakterystyki krytyczne dla biznesu. Dla sklepu internetowego będzie to zwykle wydajność i niezawodność, dla systemu bankowego bezpieczeństwo informacji, dla urządzenia medycznego bezpieczeństwo użytkowania. Te priorytety zapiszcie w planie testów, bo to one decydują, gdzie idzie najwięcej pracy.
Co zmieniło się względem wydania z 2011 roku?
Jeśli w materiałach szkoleniowych albo w starszych artykułach spotykacie listę z „przenośnością”, „użytecznością” i ośmioma cechami, to opis wydania 2011, wycofanego przez ISO. Wydanie 2023 wprowadza kilka zmian, które mają znaczenie dla testerów:
- Użyteczność zastąpiła zdolność interakcji (interaction capability), z nowymi podcharakterystykami: inkluzywność, samoopisowość i wsparcie użytkownika. Dostępność cyfrowa ma więc dziś mocniejsze oparcie w modelu jakości.
- Przenośność zastąpiła elastyczność (flexibility), a w niej pojawiła się skalowalność.
- Doszła dziewiąta charakterystyka: bezpieczeństwo użytkowania (safety), czyli unikanie stanów zagrażających życiu, zdrowiu, mieniu albo środowisku. To co innego niż bezpieczeństwo informacji (security).
- W bezpieczeństwie informacji doszła odporność (resistance): utrzymanie działania podczas ataku.
- W niezawodności dojrzałość zastąpiła bezbłędność (faultlessness): działanie bez usterek w normalnej pracy.
Jedna rzecz, której w modelu nie ma: „przydatność dokumentacji” jako osobna charakterystyka. Jakość dokumentacji użytkownika możecie oceniać, ale w ISO/IEC 25010:2023 nie jest to jedna z dziewięciu cech produktu. Jeśli Wasz szablon raportu ją tak opisuje, warto go poprawić przy najbliższej okazji.
Dlaczego opisy słowne nie wystarczą?
„Aplikacja działa stabilnie” znaczy coś innego dla testera, który widział trzy awarie w tygodniu, i dla kierownika projektu, który żadnej nie widział. Opis słowny zależy od osoby, nastroju i tego, kto akurat siedzi na spotkaniu. Liczba liczona zawsze tym samym wzorem tego problemu nie ma. Zbieranie takich liczb to zresztą jedno z zadań, w których rola testera w projekcie wykracza poza testy funkcjonalne.
Na marginesie: fraza „sprawdza jakość oprogramowania” bardzo często trafia do wyszukiwarki z dopiskiem „krzyżówka”. Jeśli tu trafiliście po hasło, odpowiedź brzmi „tester”, a jeśli zostaniecie do końca, będziecie wiedzieć także, jak ten tester liczy DDP. Różnicę między testerem a specjalistą QA opisujemy osobno w artykule co to jest QA i czym różni się od testera oprogramowania.
Jakie metryki jakości oprogramowania warto liczyć?
Poniżej siedem metryk, które w naszych projektach dają najwięcej informacji przy najmniejszym koszcie zbierania. Trzy pierwsze mówią o skuteczności testów, trzy kolejne pochodzą z badań DORA i mówią o stabilności dostarczania, ostatnia dotyczy doświadczenia użytkownika w przeglądarce.
Źródło: definicje wskaźników DORA według dora.dev (stan na styczeń 2026), progi Core Web Vitals według web.dev. Liczby w kolumnie „Przykład” są ilustracyjne.
Zwróćcie uwagę na jedną zmianę nazwy. Według przewodnika DORA zaktualizowanego w styczniu 2026 roku dawny wskaźnik MTTR zastąpił „failed deployment recovery time”, a do czterech klasycznych metryk doszła piąta, deployment rework rate. Jeśli Wasz dashboard nadal pokazuje „MTTR”, liczy prawdopodobnie coś szerszego niż odzyskiwanie po nieudanym wdrożeniu.
Jak policzyć DDP, czyli skuteczność wykrywania defektów?
DDP odpowiada na pytanie: jaką część wszystkich znalezionych defektów złapaliście sami, zanim zrobił to użytkownik. To ten sam wskaźnik, który w starszych materiałach opisywano jako „proporcję błędów z fazy produkcji do błędów z fazy odbioru”, tylko z nazwą i wzorem.
DDP = D_test / (D_test + D_prod) x 100%

D_test  = defekty znalezione w testach przed wydaniem
D_prod  = defekty zgłoszone po wydaniu w ustalonym oknie (np. 30 dni)

Przykład: 70 defektów w testach, 30 zgłoszonych z produkcji
DDP = 70 / (70 + 30) x 100% = 70%
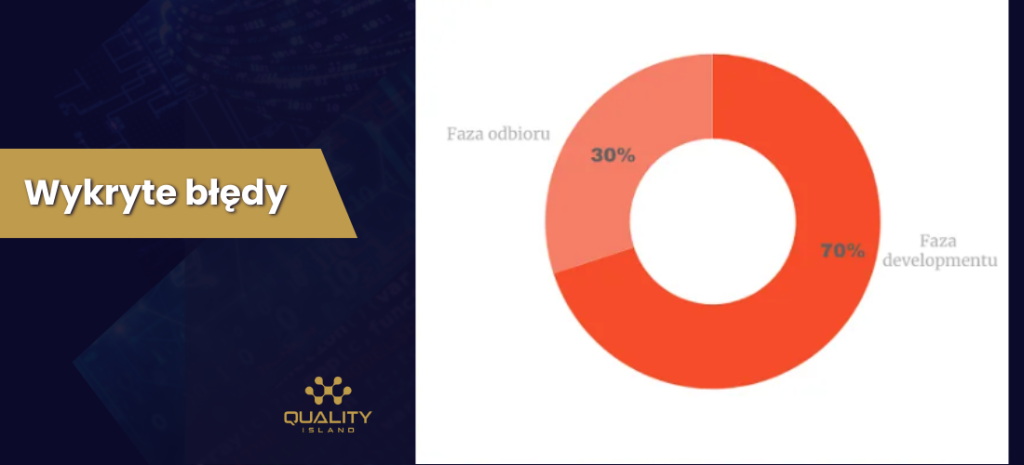
Wykres powyżej pokazuje dokładnie ten przykład: 70 procent defektów wykrytych w trakcie developmentu, 30 procent dopiero w odbiorze. Dwie zasady, bez których DDP kłamie. Po pierwsze, okno po wydaniu musi być stałe, inaczej porównujecie 7 dni z 90. Po drugie, liczcie DDP osobno dla każdej wagi błędu, bo 95 procent przy literówkach i 50 procent przy błędach krytycznych to zupełnie inna historia niż średnie 90 procent.
Dlaczego waga błędu zmienia obraz jakości?
Sama liczba defektów zrównuje literówkę w stopce z błędem, który blokuje płatność. Dlatego do każdej metryki opartej na liczbie defektów dodajcie wagę. Prosty sposób to wagi punktowe, ustalone raz dla całego zespołu i zapisane w procesie zgłaszania błędów.
Przykładowe wagi: bloker 10, krytyczny 5, wysoki 3, niski 1

Sprint A: 12 defektów niskich              = 12 x 1        = 12 pkt
Sprint B: 1 bloker + 2 krytyczne           = 1 x 10 + 2 x 5 = 20 pkt

Sprint A ma 4 razy więcej defektów, a mimo to jest zdrowszy.
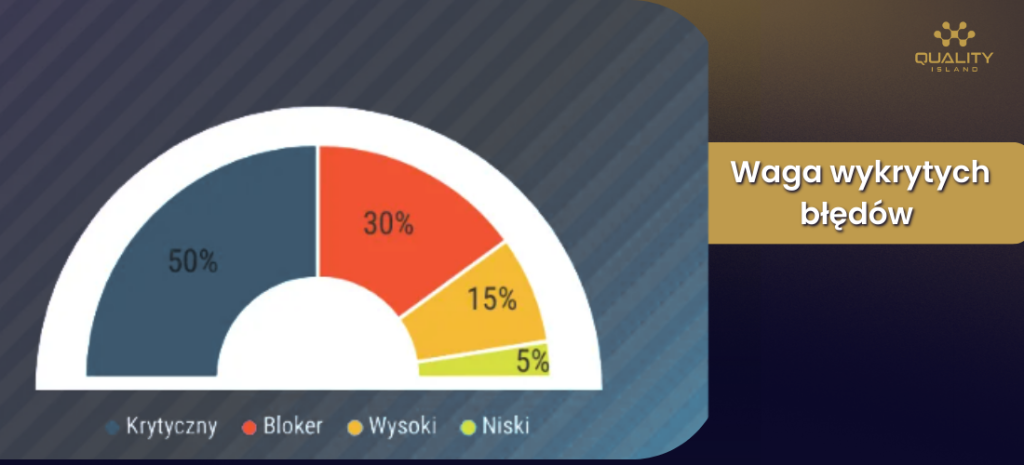
Wykres to przykładowy rozkład wag z jednego okresu, nie dane rynkowe. Druga oś, o której łatwo zapomnieć, to trudność wystąpienia. Błąd krytyczny, który pojawia się przy pierwszym logowaniu, świadczy o jakości dużo gorzej niż błąd krytyczny wymagający rzadkiej kombinacji ustawień. Warto oznaczać przy zgłoszeniu, czy defekt leży na ścieżce głównej, czy na rzadkim scenariuszu brzegowym. O tym, jak dobrze opisać zgłoszenie, piszemy w przewodniku jak poprawnie zgłosić błąd, a analizę przyczyn ćwiczymy na szkoleniu analiza defektów: jak wyciągać wnioski i poprawiać jakość.
Jakie progi ustawić i w jakie pułapki nie wpaść?
Metryka bez progu to liczba, na którą nikt nie reaguje. Tam, gdzie istnieją progi zewnętrzne, korzystajcie z nich. Według web.dev dobre doświadczenie użytkownika oznacza LCP do 2,5 sekundy, INP do 200 milisekund i CLS do 0,1, mierzone na 75. percentylu odsłon. Dla metryk wewnętrznych, takich jak DDP, ustalcie próg z historii własnego produktu: weźcie medianę z ostatnich trzech wydań i traktujcie spadek o więcej niż 10 punktów procentowych jako sygnał do przeglądu.
Wbrew pozorom
Próg potrafi zaszkodzić jakości. Autorzy książki „Software Engineering at Google” z 2020 roku opisują, co dzieje się, gdy zespół ustala wymóg 80 procent pokrycia kodu testami: inżynierowie zaczynają traktować 80 procent nie jak minimum, tylko jak sufit, i zmiany lądują z pokryciem dokładnie na granicy. Przewodnik DORA z 2026 roku ostrzega przed tym samym, przywołując prawo Goodharta: gdy miara staje się celem, przestaje być dobrą miarą.
Trzy pułapki, które widzimy najczęściej u klientów przy audycie QA:
- Jedna metryka do wszystkiego. Sam DDP nie pokaże, że testy trwają dwa tygodnie. Łączcie metryki skuteczności z metrykami tempa, tak jak robi to DORA, łącząc przepustowość z niestabilnością.
- Porównywanie zespołów. DORA wprost odradza porównywanie wskaźników między bardzo różnymi aplikacjami, na przykład aplikacją mobilną i systemem mainframe. Porównujcie produkt z nim samym w czasie.
- Liczenie zamiast naprawiania. Jakość rośnie wtedy, gdy defekty są usuwane, a ich przyczyny eliminowane, nie wtedy, gdy rośnie liczba zgłoszeń w systemie.
Jak połączyć metryki z głosem użytkowników?
Liczby z testów mówią, co znaleźliście. Użytkownicy mówią, co ich boli. Dobrze ułożony pomiar jakości oprogramowania zestawia oba źródła: zgłoszenia z działu wsparcia, oceny w sklepie z aplikacjami, wyniki ankiet po kluczowych zadaniach. Jeśli DDP wynosi 90 procent, a liczba zgłoszeń do wsparcia rośnie, to Wasze testy szukają w złych miejscach i trzeba przesunąć scenariusze tam, gdzie pracują ludzie.
Najmocniejszy dowód, że to działa, to zmiana wyniku biznesowego. W projekcie dla Argos z branży e-commerce automatyzacja testów i uporządkowanie procesów QA przełożyły się na liczby, które klient potwierdził:
Argos, e-commerce: jakość zmierzona po współpracy
−72%
awarii w okresach szczytowych
−46%
błędów krytycznych na produkcji
+12%
konwersji dzięki stabilnemu checkoutowi
10 godzin
regresji przed wydaniem, wcześniej 5 dni
Źródło: dane Quality Island, case study Argos, liczby potwierdzone przez klienta.
Zauważcie, że dwie z tych liczb to metryki jakości (awarie, błędy krytyczne), a dwie to metryki biznesowe (konwersja, czas wydania). Zarząd słucha tych drugich. Jak przełożyć wyniki QA na język finansów, pokazujemy w artykule KPI dla zarządu: jak mówić o QA językiem CFO. Raport CISQ z 2022 roku szacuje koszt złej jakości oprogramowania w samych Stanach Zjednoczonych na co najmniej 2,41 biliona dolarów, więc rozmowa o pomiarze jakości jest rozmową o pieniądzach, nie o estetyce kodu. Szerzej o tym, jak lepsze QA obniża koszty utrzymania systemu, pisze Strefa QA w analizie kosztów utrzymania oprogramowania.
Od czego zacząć pomiar w Waszym zespole?
Nie zaczynajcie od kupna narzędzia do dashboardów. Zacznijcie od czterech kroków, które da się zrobić w miesiąc na danych, które już macie w systemie zgłoszeń i w potoku CI.
- Wybierzcie dwie lub trzy charakterystyki z ISO/IEC 25010:2023, które są krytyczne dla Waszego produktu, i zapiszcie je razem z właścicielem biznesowym.
- Ustalcie wagi błędów i okno po wydaniu (na przykład 30 dni), żeby DDP i defekty, które uciekły, były porównywalne między wydaniami.
- Policzcie wartości bazowe z trzech ostatnich wydań: DDP według wag, change fail rate, czas przywrócenia po nieudanym wdrożeniu.
- Dodajcie jedną liczbę biznesową, która reaguje na jakość: zgłoszenia do wsparcia, konwersję albo czas regresji, i raportujcie ją obok metryk testowych w każdym raporcie z testów.
Jeśli chcecie, żeby ktoś z zewnątrz ułożył ten system razem z Wami, zrobimy to w ramach audytu procesów QA. Zespoły, które wolą nauczyć się tego samodzielnie, szkolimy z raportowania i analizy danych testowych oraz z tego, jak mierzyć ROI z procesów testowych.
Co zabrać z tego artykułu
01Aktualny model to ISO/IEC 25010:2023 z dziewięcioma charakterystykami. Wydanie 2011 jest wycofane, a „przydatność dokumentacji” nie jest charakterystyką normy.
02Nowe w 2023: zdolność interakcji zamiast użyteczności, elastyczność zamiast przenośności i dziewiąta cecha, bezpieczeństwo użytkowania.
03DDP = defekty z testów / (z testów + z produkcji) × 100. Liczcie je przy stałym oknie po wydaniu i osobno dla każdej wagi.
04DORA mierzy dziś pięć wskaźników, a MTTR zastąpił czas przywrócenia po nieudanym wdrożeniu.
05Próg zamieniony w cel przestaje mierzyć jakość. Porównujcie produkt z nim samym w czasie, nie zespoły między sobą.
Chcecie wiedzieć, jaka jest dziś jakość Waszego produktu w liczbach, a nie w odczuciach? Audyt QA kończy się zestawem metryk, wartościami bazowymi i listą zmian w kolejności od największego efektu.
Powiązane na blogu Quality Island
- KPI dla zarządu: jak przełożyć wyniki QA na język, który rozumie CFO
- Kto naprawdę odpowiada za jakość oprogramowania?
- Raport z testów: co musi się w nim znaleźć
- Testy wydajnościowe: rodzaje, metryki i narzędzia
- Jak skrócić testy regresyjne z 5 dni do 10 godzin: case Argos
Pełna lista źródeł
- ISO, ISO/IEC 25010:2023 Systems and software engineering, SQuaRE, Product quality model, wydanie 2, 2023. Stąd dziewięć charakterystyk, zakres zastosowań modelu i status wydania 2011 jako wycofanego (sprawdzone na iso.org 10.10.2026).
- iso25000.com, ISO/IEC 25010, opis charakterystyk i podcharakterystyk, stan na 2026. Stąd lista podcharakterystyk w tabeli.
- DORA, DORA’s software delivery performance metrics, aktualizacja 5 stycznia 2026. Stąd pięć wskaźników, zastąpienie MTTR i ostrzeżenia przed porównywaniem zespołów.
- Google, web.dev, Web Vitals, 2024. Stąd progi LCP 2,5 s, INP 200 ms i CLS 0,1.
- Titus Winters, Tom Manshreck, Hyrum Wright, Software Engineering at Google, rozdział 11: Testing Overview, 2020. Stąd przykład progu pokrycia 80 procent traktowanego jak sufit.
- CISQ, The Cost of Poor Software Quality in the US: A 2022 Report, 2022. Stąd koszt złej jakości oprogramowania w USA, co najmniej 2,41 biliona dolarów.
- Dane własne Quality Island, 2026: case study Argos z liczbami potwierdzonymi przez klienta.

 1 dzień