09.03.2026
 Tomasz Stelmach
Czas czytania: około 12 minut
Lekcja 1 darmowego kursu SQL dla testerów. Zaczynamy od fundamentu: czym jest baza danych, czym różni się od arkusza, co robi DBMS i dlaczego tester, który potrafi zajrzeć do bazy, zgłasza lepsze błędy niż ten, który ogląda tylko ekran.
Jeśli w projekcie ktoś mówi „to pewnie dane w bazie się rozjechały”, a Wy nie wiecie, jak to sprawdzić, ta lekcja jest dla Was.
Spis treści
- Co to jest baza danych
- Tabela, wiersz, kolumna i klucz, czyli baza danych na przykładzie
- Baza danych a arkusz kalkulacyjny
- DBMS, czyli kto pilnuje danych
- Rodzaje baz danych i kiedy której używać
- Najpopularniejsze bazy danych w 2026 roku
- SQL, czyli język, którym pytacie bazę o dane
- Transakcje i ACID w pracy testera
- Pięć sytuacji, w których tester zagląda do bazy
- Od czego zacząć naukę baz danych
- Siedem błędów przy pracy z bazą w testach
- Co dalej w kursie SQL dla testerów
Co to jest baza danych
Baza danych to uporządkowany zbiór danych przechowywany w formie elektronicznej i zarządzany przez system zarządzania bazą danych, czyli DBMS. Dane, DBMS i korzystające z nich aplikacje tworzą razem system bazodanowy, który w mowie potocznej nazywamy po prostu bazą danych.
Kluczowe słowo w tej definicji to uporządkowany. Plik z notatkami też przechowuje dane, ale nikt nie nazwie go bazą danych, bo nie ma w nim struktury, której trzymają się wszystkie zapisy. W bazie danych struktura jest umową: każdy klient ma imię, nazwisko i adres e-mail, każde zamówienie ma numer, datę i kwotę. Dzięki tej umowie maszyna potrafi w ułamku sekundy znaleźć jedno zamówienie wśród dziesięciu milionów.
Dane to informacje odnoszące się do konkretnej rzeczy. Kolor, rocznik, przebieg i marka to dane Waszego samochodu. Metraż, liczba pokoi i piętro to dane Waszego mieszkania. Baza danych bierze takie informacje i układa je tak, żeby dało się je szybko zapisać, znaleźć, zmienić i usunąć. Te cztery operacje wracają w każdej lekcji tego kursu, bo to na nich stoi cała praca z danymi.
W wielu zespołach baza danych ma status szafy, do której zagląda jedna osoba i najlepiej w piątek po południu. Szkoda, bo to najuczciwszy świadek w całym projekcie: aplikacja może Wam pokazać ładny komunikat o sukcesie, a baza i tak powie, czy cokolwiek się zapisało.
Tabela, wiersz, kolumna i klucz, czyli baza danych na przykładzie
Najprostszy model, od którego warto zacząć, to baza relacyjna. Dane leżą w tabelach, tabela ma kolumny (co przechowujemy) i wiersze (konkretne zapisy). Wyobraźcie sobie sklep internetowy i tabelę klienci:
| Kolumna | Typ danych | Przykładowa wartość | Do czego służy |
|---|---|---|---|
| id | liczba całkowita | 1041 | klucz główny, unikalny identyfikator wiersza |
| imie | tekst | Anna | dane osobowe klienta |
| tekst | anna@example.com | wartość unikalna, po niej logujemy | |
| data_rejestracji | data i czas | 2026-02-11 09:14 | kiedy konto powstało |
| aktywny | wartość logiczna | prawda | czy konto jest włączone |
Druga tabela, zamowienia, trzyma numer zamówienia, kwotę, status i kolumnę klient_id. To właśnie klucz obcy: wskazuje wiersz w tabeli klienci i tworzy relację między dwiema tabelami. Stąd nazwa: baza relacyjna. Dzięki relacjom nie powtarzacie adresu klienta przy każdym zamówieniu, tylko trzymacie go w jednym miejscu, a reszta systemu się do niego odwołuje.
Zapamiętajcie tę parę pojęć, bo wraca w każdym zgłoszeniu błędu, które dotyczy danych. Jeśli w systemie da się utworzyć zamówienie bez istniejącego klienta, to nie jest kaprys testera, tylko dziura w modelu danych.
Baza danych a arkusz kalkulacyjny
Najczęstsze pytanie na pierwszym szkoleniu brzmi: skoro mam arkusz, po co mi baza. Odpowiedź nie brzmi „bo baza jest lepsza”, tylko „bo obie służą do czego innego”.
| Kryterium | Baza danych | Arkusz kalkulacyjny |
|---|---|---|
| Wielu użytkowników naraz | Dziesiątki tysięcy równoległych sesji, każda widzi spójny stan | Jeden edytujący, reszta ogląda kopię |
| Skala danych | Miliardy wierszy, jeśli sprzęt i model na to pozwalają | Praktyczny limit to setki tysięcy wierszy |
| Spójność | Klucze, ograniczenia i transakcje pilnują reguł | Reguły pilnuje osoba, która pamiętała o formule |
| Historia zmian | Dziennik transakcji, kopie zapasowe, odtwarzanie do punktu w czasie | Kolejne pliki z dopiskiem „final2″ |
| Uprawnienia | Dostęp na poziomie tabeli, kolumny i wiersza | Hasło do pliku albo zaufanie |
| Koszt wejścia | Wyższy: instalacja, model danych, utrzymanie | Niższy: otwieracie i piszecie |
Arkusz jest świetny do jednorazowej analizy i do rozmowy z biznesem. Baza jest jedynym sensownym miejscem na dane, z których korzysta aplikacja i wielu ludzi naraz. Granica przebiega tam, gdzie pojawia się drugi użytkownik i pierwsze pytanie „która wersja pliku jest aktualna”.
DBMS, czyli kto pilnuje danych
DBMS, czyli system zarządzania bazą danych, to oprogramowanie, które stoi między Waszym zapytaniem a plikami na dysku. Bez niego baza jest zbiorem bajtów. To DBMS decyduje, kto ma prawo czytać, jak pogodzić dwie równoczesne zmiany tego samego wiersza i co zrobić, gdy w połowie operacji zabraknie prądu.
Warto znać ten podział, bo w zgłoszeniach błędów regularnie myli się bazę z systemem, który nią zarządza. „Baza padła” najczęściej znaczy „usługa DBMS nie odpowiada”, a to zupełnie inny trop w diagnozie niż uszkodzone dane.
Rodzaje baz danych i kiedy której używać
Relacyjne to nie jedyny rodzaj baz. Poniższa tabela porządkuje te, które spotkacie w projektach najczęściej, razem z sytuacją, w której dany model ma sens:
| Rodzaj | Jak trzyma dane | Kiedy ma sens | Przykłady |
|---|---|---|---|
| Relacyjne | Tabele, wiersze, relacje, język SQL | Systemy transakcyjne, finanse, sprzedaż, dane, na które patrzy audyt | PostgreSQL, MySQL, Oracle, MS SQL Server |
| Dokumentowe | Dokumenty JSON zamiast wierszy | Dane o zmiennej strukturze, katalogi produktów, treści | MongoDB |
| Klucz i wartość | Prosta para: klucz oraz wartość | Sesje, koszyki, pamięć podręczna, liczniki | Redis |
| Grafowe | Węzły i połączenia między nimi | Rekomendacje, sieci powiązań, wykrywanie nadużyć | Neo4j, rozszerzenia grafowe w bazach relacyjnych |
| Kolumnowe i hurtownie | Dane trzymane kolumnami, pod analitykę | Raporty, analizy na wielkich zbiorach, dane historyczne | Snowflake, Databricks |
| Wyszukiwania | Indeks pełnotekstowy i wektorowy | Wyszukiwarki w produkcie, podpowiedzi, funkcje AI | Elasticsearch |
Podział bywa mniej ostry, niż sugerują tabele. Według zestawienia DB-Engines z września 2026 większość czołowych systemów opisuje się dziś jako multi-model: jedna baza obsługuje i tabele, i dokumenty JSON, i zapytania wektorowe. Standard nadąża za praktyką. Norma ISO/IEC 9075 w edycji z 2023 roku dołożyła część 16, SQL/PGQ, czyli zapytania grafowe w zwykłym SQL.
Dla testera wniosek jest prosty: pytanie „czy to relacyjna, czy NoSQL” bywa dziś mniej ważne niż pytanie „jakie gwarancje spójności daje nam ta konkretna konfiguracja”. Do tego drugiego pytania wracamy w sekcji o transakcjach. Jeśli pracujecie z bazami nierelacyjnymi na co dzień, osobne szkolenie z baz NoSQL pokazuje różnice na przykładach, a nie na slajdach.
Najpopularniejsze bazy danych w 2026 roku
Poprzednia wersja tej lekcji podawała listę z ankiety z 2019 roku. Odświeżamy ją danymi odczytanymi 9 września 2026. Zestawienie DB-Engines, aktualizowane co miesiąc, obejmuje 438 systemów i porządkuje je według popularności mierzonej między innymi liczbą wzmianek, ofert pracy i pytań technicznych.
| Miejsce | System | Model | Punkty | Zmiana rok do roku |
|---|---|---|---|---|
| 1 | Oracle | relacyjna, multi-model | 1122,27 | minus 48,36 |
| 2 | MySQL | relacyjna, multi-model | 844,82 | minus 46,95 |
| 3 | Microsoft SQL Server | relacyjna, multi-model | 698,69 | minus 18,63 |
| 4 | PostgreSQL | relacyjna, multi-model | 683,26 | plus 26,08 |
| 5 | MongoDB | dokumentowa, multi-model | 381,31 | plus 0,81 |
| 6 | Snowflake | relacyjna, hurtownia | 211,61 | plus 21,42 |
| 7 | Databricks | multi-model | 168,34 | plus 44,27 |
| 8 | Redis | klucz i wartość | 158,06 | plus 12,89 |
| 9 | IBM Db2 | relacyjna, multi-model | 110,57 | minus 13,61 |
| 10 | SQLite | relacyjna, wbudowana | 97,05 | minus 10,83 |
Z danych DB-Engines wynika jedna rzecz, którą warto zapamiętać przy planowaniu nauki: w pierwszej czwórce tylko PostgreSQL rośnie rok do roku, o 26,08 punktu, podczas gdy Oracle traci 48,36, a MySQL 46,95. Ten sam kierunek pokazuje ankieta Stack Overflow Developer Survey 2025: PostgreSQL wskazało 55,6 procent z 26 083 odpowiadających, MySQL 40,5 procent, a SQLite 37,5 procent. Wśród samych zawodowych programistów PostgreSQL sięga 58,2 procent.
Najpopularniejsza baza danych świata nie stoi na żadnym serwerze. Twórcy SQLite szacują, że w aktywnym użyciu jest ponad bilion baz SQLite, bo silnik siedzi w każdym telefonie, przeglądarce i samochodowym systemie multimedialnym. W rankingach popularności SQLite bywa dopiero w okolicach dziesiątego miejsca, a mimo to prawdopodobnie dotykacie go kilkadziesiąt razy dziennie, nie wiedząc o tym.
SQL, czyli język, którym pytacie bazę o dane
SQL, czyli Structured Query Language, to język, którym rozmawiacie z bazą relacyjną. Powstał w firmie IBM w latach siedemdziesiątych, a od 1986 roku jest normalizowany. Najnowsze wydanie to ISO/IEC 9075-1:2023, szósta edycja normy, opublikowana w czerwcu 2023 roku. To ważne, bo tłumaczy, dlaczego zapytanie napisane dla PostgreSQL zwykle zadziała w MySQL, a mimo to potrafi się wyłożyć na jednej funkcji: producenci dokładają do wspólnej normy własne rozszerzenia, zwane dialektami.
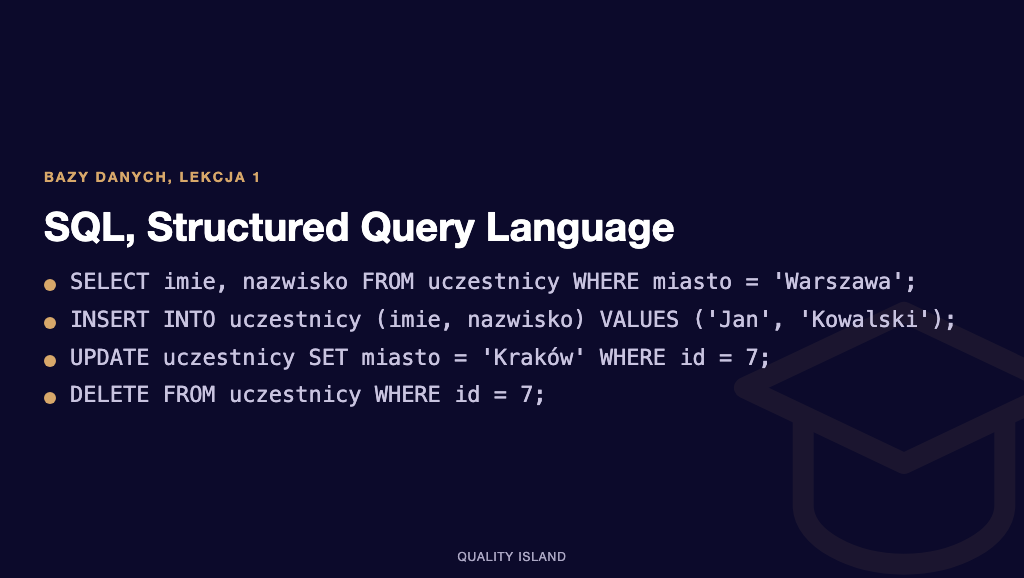
Cztery polecenia załatwiają większość codziennej pracy testera. Poniżej macie je na tabelach ze sklepu z sekcji drugiej:
-- 1. Odczyt: wszystkie zamowienia jednego klienta, od najnowszego
SELECT numer, kwota, status, data_utworzenia
FROM zamowienia
WHERE klient_id = 1041
ORDER BY data_utworzenia DESC;

-- 2. Odczyt z dwoch tabel naraz, czyli zlaczenie
SELECT k.imie, k.email, z.numer, z.kwota
FROM klienci k
JOIN zamowienia z ON z.klient_id = k.id
WHERE z.status = 'oplacone';

-- 3. Zapis nowego wiersza
INSERT INTO klienci (imie, email, aktywny)
VALUES ('Anna', 'anna@example.com', true);

-- 4. Zmiana i usuniecie, zawsze z warunkiem WHERE
UPDATE zamowienia SET status = 'anulowane' WHERE numer = 'ZAM-2026-0187';
DELETE FROM koszyki WHERE data_utworzenia < '2026-01-01';
Zwróćcie uwagę na ostatnią linię. UPDATE i DELETE bez warunku WHERE dotyczą całej tabeli. To najczęstszy sposób, w jaki tester psuje sobie środowisko testowe przed demem. Dobra praktyka: najpierw ten sam warunek w zapytaniu SELECT, policzcie wiersze, dopiero potem zamieńcie SELECT na UPDATE. Składnię ćwiczymy od podstaw na szkoleniu SQL w praktyce, a raportowanie i analizę na szkoleniu z analizy danych w SQL.
Transakcje i ACID w pracy testera
Transakcja to zestaw operacji traktowany jako jedna całość. Przelew to klasyczny przykład: odjęcie kwoty z jednego konta i dodanie jej do drugiego musi wykonać się w komplecie albo wcale. Skrót ACID opisuje cztery gwarancje: atomowość, spójność, izolację i trwałość.
BEGIN;
UPDATE konta SET saldo = saldo - 500 WHERE id = 1;
UPDATE konta SET saldo = saldo + 500 WHERE id = 2;
COMMIT;    -- obie zmiany widoczne dla innych
-- ROLLBACK; -- albo zadna z nich, jesli cos poszlo nie tak
Najciekawsza dla testera jest izolacja, bo to ona rozstrzyga, co widzi jedna transakcja, gdy druga jeszcze trwa. Dokumentacja PostgreSQL 18 podaje, że domyślnym poziomem izolacji jest READ COMMITTED: zapytanie widzi wyłącznie dane zatwierdzone przed jego rozpoczęciem. To wyjaśnia sytuację, którą widzieliśmy w niejednym projekcie: test automatyczny czyta rekord, którego druga sesja jeszcze nie zatwierdziła, i przewraca się „bez powodu”.
Pytanie, które warto zadać deweloperowi, brzmi więc nie „czy to działa”, tylko „na jakim poziomie izolacji to działa i co się stanie, gdy dwie osoby klikną w tej samej sekundzie”. To jest dokładnie ten moment, w którym tester znający bazę przestaje być osobą klikającą, a zaczyna być osobą, której deweloperzy słuchają.
Pięć sytuacji, w których tester zagląda do bazy
Teoria bez zastosowania szybko wyparowuje, więc pięć sytuacji z naszych projektów, w których zaglądanie do bazy było różnicą między zgłoszeniem „nie działa” a zgłoszeniem, które deweloper naprawił tego samego dnia:
W naszych projektach automatyzacyjnych zapytania SQL są stałym elementem zestawu testów, nie ciekawostką dla zaawansowanych. Z naszego doświadczenia zespół, który przygotowuje dane testowe zapytaniem zamiast klikaniem, skraca przygotowanie środowiska z godzin do minut, a przy okazji przestaje uzależniać wynik testu od stanu, który ktoś zostawił poprzedniego dnia. W projekcie dla firmy Argos uporządkowanie procesów i automatyzacja skróciły regresję przed wydaniem z 5 dni do 10 godzin, a liczba błędów krytycznych na produkcji spadła o 46 procent.
Jeśli budujecie taki zestaw u siebie, warto zacząć od miejsca, w którym dane są najbardziej wrażliwe. Więcej o tym, ile kosztuje niedopilnowana warstwa danych, znajdziecie w tekście Ile kosztuje luka bezpieczeństwa, której nikt nie szukał na Strefie QA. Wsparcie po naszej stronie zaczyna się zwykle od testów oprogramowania i uporządkowania testów regresyjnych.
Od czego zacząć naukę baz danych
W tym kursie pracujemy na PostgreSQL. Wybór nie jest przypadkowy: to baza w pełni darmowa, na licencji open source, więc możecie ją zainstalować na własnym komputerze bez rozmowy z działem zakupów. Jest też jedynym systemem z czołówki zestawienia DB-Engines, który rośnie rok do roku, a w badaniu Stack Overflow 2025 prowadzi z wynikiem 55,6 procent. Umiejętność, którą tu zdobędziecie, ma więc rosnący, a nie kurczący się rynek.
Plan na start, sprawdzony na uczestnikach, których szkolimy:
- Zainstalujcie PostgreSQL i narzędzie graficzne, na przykład pgAdmin. Pierwsze uruchomienie zajmuje kwadrans.
- Odtwórzcie tabele klienci i zamowienia z tej lekcji i wpiszcie do nich dziesięć wierszy ręcznie.
- Napiszcie pięć zapytań SELECT: wszystko, z warunkiem, z sortowaniem, z liczeniem i ze złączeniem dwóch tabel.
- Zepsujcie coś celowo: spróbujcie dodać zamówienie z nieistniejącym klientem i zobaczcie, jak baza Was zatrzymuje.
- Dopiero potem przejdźcie do zmian danych, czyli INSERT, UPDATE i DELETE, zawsze z warunkiem.
Kolejne kroki znajdziecie w lekcji 6 z warsztatem PostgreSQL oraz w osobnym warsztacie PostgreSQL. Jeśli wolicie uczyć się z książką albo z kursem wideo, mamy dwa zestawienia: pięć najlepszych książek do nauki SQL i przegląd kursów SQL na Udemy. A jeśli wolicie zrobić to z trenerem i na danych podobnych do Waszych, najbliżej tej lekcji jest szkolenie Bazy danych, język SQL dla testerów, a wersję dla osób pracujących z samą bazą znajdziecie w szkoleniu kompleksowym z PostgreSQL.
Siedem błędów przy pracy z bazą w testach
- UPDATE albo DELETE bez WHERE. Jedna sekunda, cała tabela. Najpierw SELECT z tym samym warunkiem, potem zmiana.
- Testowanie na kopii sprzed miesiąca. Dane, które nie odpowiadają obecnemu modelowi, produkują błędy, których nie ma w produkcie.
- Zakładanie, że baza jest pusta. Test, który liczy na konkretne identyfikatory, przewróci się przy pierwszym równoległym przebiegu.
- Mylenie braku wartości z zerem. W SQL wartość NULL to „nie wiadomo”, a nie „zero”, i porównanie z nią nigdy nie zwróci prawdy.
- Sprawdzanie tylko warstwy widocznej. Zielony komunikat na ekranie nie jest dowodem zapisu w bazie.
- Praca na produkcji „tylko do odczytu”. Do pierwszej pomyłki w oknie zapytania. Osobne środowisko kosztuje mniej niż jedna taka pomyłka.
- Sklejanie zapytań z danych użytkownika. To prosta droga do wstrzyknięcia SQL, czyli jednej z najstarszych i wciąż najskuteczniejszych podatności.
Co dalej w kursie SQL dla testerów
Macie już fundament: wiecie, czym jest baza danych, czym różni się od arkusza, co robi DBMS, jakie są rodzaje baz i jak wygląda pierwsze zapytanie. W kolejnych lekcjach schodzimy głębiej w SQL i w PostgreSQL, a każda lekcja kończy się ćwiczeniem, które możecie wykonać na własnym komputerze.
Jeśli chcecie przejść tę drogę szybciej i z kimś, kto poprawi Wasze zapytania na bieżąco, zajrzyjcie do kalendarza szkoleń. Terminy otwarte prowadzimy w małych grupach, a dla zespołów układamy program pod dane, na których naprawdę pracujecie.
Co zabrać z tego artykułu
01Baza danych to uporządkowany zbiór danych zarządzany przez DBMS. Uporządkowanie, nie ilość, jest tu słowem kluczowym.
02W bazie relacyjnej dane leżą w tabelach, a klucz główny i klucz obcy pilnują, żeby nie powstały zamówienia bez klienta.
03Arkusz przegrywa z bazą tam, gdzie pojawia się drugi użytkownik, transakcja i wymóg historii zmian.
04Zestawienie DB-Engines z września 2026 obejmuje 438 systemów, a w czołowej czwórce rośnie tylko PostgreSQL.
05Domyślny poziom izolacji w PostgreSQL to READ COMMITTED i to on tłumaczy część „losowych” błędów w testach równoległych.
06UPDATE i DELETE bez warunku WHERE dotyczą całej tabeli. Ta jedna zasada oszczędzi Wam najwięcej nerwów.
Chcecie, żeby Wasz zespół czytał dane z bazy zamiast zgadywać z ekranu? Szkolenie „Bazy danych, język SQL dla testerów” przechodzi od pierwszego SELECT do zapytań, które realnie skracają analizę defektu.
Powiązane na blogu Quality Island
- Lekcja 6: PostgreSQL, warsztat
- PostgreSQL: warsztat od instalacji do pierwszych zapytań
- Pięć najlepszych książek do nauki SQL
- Top kursy Udemy: SQL
- Testowanie aplikacji webowych: co sprawdzić i czym
- Metody HTTP: GET, POST, PUT, PATCH i DELETE w testach API
Pełna lista źródeł
- DB-Engines Ranking, wrzesień 2026, 438 systemów, punktacja popularności, odczyt 09.09.2026
- Stack Overflow Developer Survey 2025, sekcja Databases, 26 083 odpowiedzi, odczyt 09.09.2026
- ISO/IEC 9075-1:2023, Database languages SQL, Part 1: Framework, szósta edycja, czerwiec 2023
- PostgreSQL 18 Documentation, 13.2 Transaction Isolation, poziom domyślny READ COMMITTED, odczyt 09.09.2026
- SQLite, Most Widely Deployed SQL Database Engine, szacunek ponad biliona baz, aktualizacja 21.04.2026
- Dane własne Quality Island: efekty projektu dla firmy Argos, baza marketingowa 2026

 2 dni